llms.txt советуют GigaChat и ChatGPT, а Алиса — ни разу
llms.txt советуют GigaChat и ChatGPT, а Алиса AI, Google и Claude — нет. Что это за файл, пример, нужен ли он сайту и почему Google его не использует.
Читать статью →Что такое RAG простыми словами: как нейросеть ищет документы перед ответом, почему Алиса AI берёт в ответ блок из пяти сайтов выдачи и что это значит для видимости бизнеса в ИИ.
Что такое RAG: это механизм, при котором нейросеть перед ответом ищет документы во внешней базе и отвечает по ним. Если коротко, RAG в ИИ — это способ отвечать не по памяти, а по свежим источникам.
Для бизнеса из этого следует главное: в ответ попадают несколько найденных сайтов, у Алисы AI обычно пять, и бороться приходится за эти места. Когда Perplexity отвечает на ваш вопрос и внизу ставит четыре ссылки на источники — это работает RAG. Когда Алиса зачитывает один ответ вслух и он опирается на конкретные сайты — это тоже RAG. Расшифровка тоже отвечает на вопрос, что такое RAG: Retrieval-Augmented Generation, «генерация, дополненная поиском». Если вы занимаетесь маркетингом и хотите, чтобы нейросети упоминали вашу компанию, разобраться в RAG нужно раньше, чем в любых тактиках. Потому что от того, как устроен этот механизм, зависит, попадёте вы в ответ ИИ или нет.
На вопрос, что такое RAG-система, инженеры отвечают так: это система Retrieval Augmented Generation (RAG) из двух частей — модуля поиска и языковой модели. Поэтому RAG-модель — не отдельная нейросеть, а языковая модель, которой дали поиск по внешней базе знаний. Термин ввела команда исследователей из Facebook AI (сейчас Meta) в статье 2020 года — авторы предложили дополнять генеративную модель модулем извлечения фактов из внешнего источника.
Обычная языковая модель без RAG обучена на огромном массиве текстов и хранит знания в своих весах — в памяти, зашитой на этапе обучения. У такой памяти два больных места. Первое — она устаревает: модель с обучением до 2024 года не знает, что случилось в 2026-м. Второе — она любит выдумывать: когда фактов не хватает, модель достраивает ответ правдоподобной ерундой, и это называют галлюцинациями.
Вместо того чтобы полагаться только на память, RAG на каждый запрос лезет в свежий внешний источник — веб-индекс, базу документов, справочник — вытаскивает подходящие куски и передаёт их модели вместе с вопросом. Модель отвечает уже не по памяти, а по документам, которые лежат прямо перед ней. Как студент, которому на экзамене разрешили открыть учебник на нужной странице.
Мест в ответе нейросети немного, и у Алисы AI это видно особенно чётко. Мы пересчитали 526 ответов Алисы AI, снятых в наших замерах с июня по октябрь 2026 года. Источники приложены к каждому из них. Ровно пять источников — в 338 ответах (64%), десять — в 130 (25%). Остальные варианты встречаются редко. Получается, что система берёт из выдачи блок, а не подбирает источники по одному под каждый абзац.
Второе наблюдение — набор устойчив. Мы сравнивали ответы на один и тот же вопрос, заданный повторно в одном прогоне: какую долю от всех разных ссылок двух ответов составляют общие. У Алисы AI это в среднем 82%, у ChatGPT с поиском — 46% (архив прогонов на сентябрь 2026 года). Это сходится с отчётом Ашманова: Алиса ищет в органике Яндекса и отбирает источники из верхних результатов, поэтому видимость в ней ведёт себя как позиция в выдаче.
Для бизнеса вывод простой. В ответе Алисы вы конкурируете за пять мест, и эти места почти не меняются, когда тот же вопрос задают снова. Если вас нет в верхней части выдачи по вопросу клиента, модель не увидит ваш сайт, сколько бы раз вопрос ни задавали. Если вы там есть, вас будут цитировать стабильно.
RAG проходит четыре шага: запрос превращается в вектор, система ищет по векторной базе близкие по смыслу фрагменты, найденное подклеивают к вопросу в один промпт, и модель пишет ответ по этим фрагментам со ссылками на источники. Когда вы задаёте вопрос нейропоиску, под капотом происходит именно это.
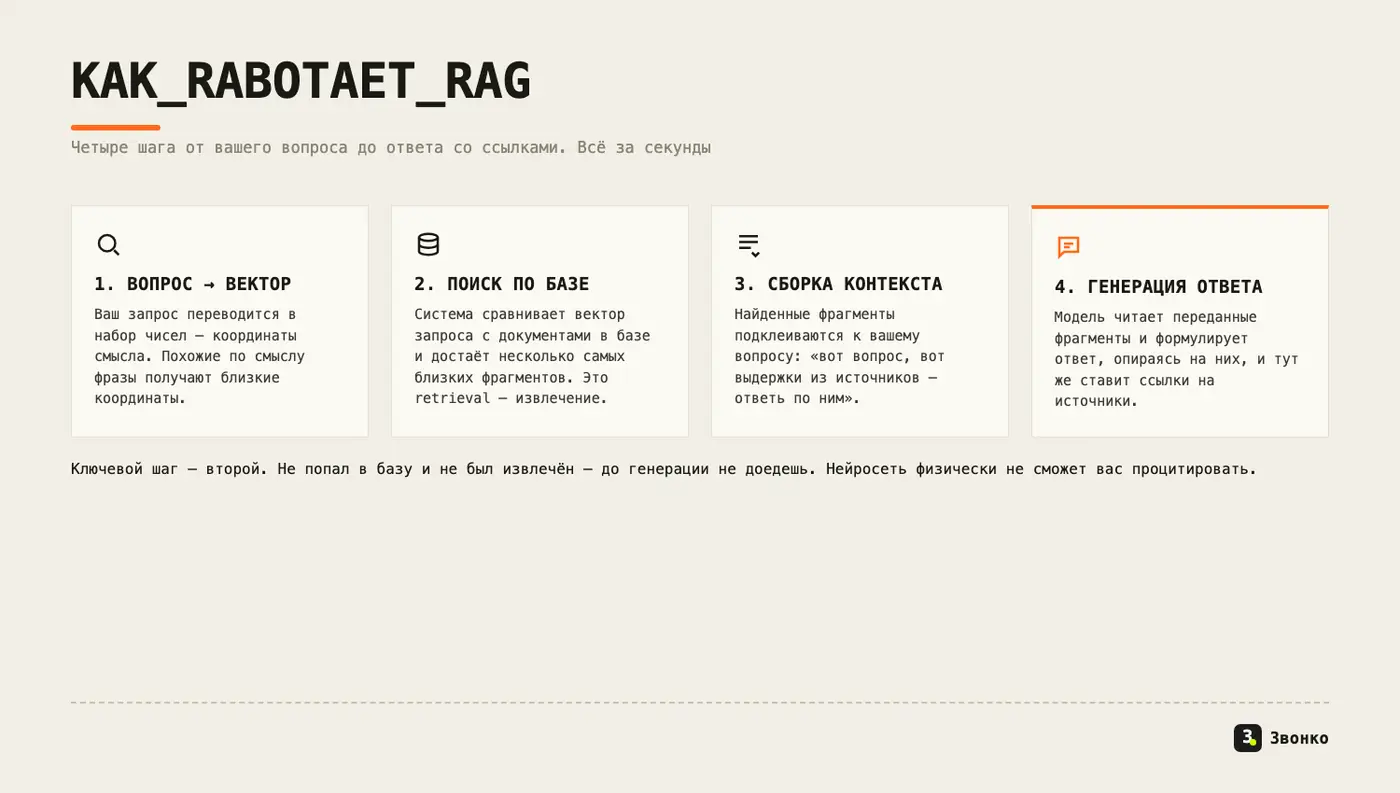
Весь путь занимает секунды, и пользователь видит только финал — связный ответ со сносками. Но для маркетолога важен второй шаг. Если ваш сайт не попал в базу и не был извлечён на шаге поиска, до генерации он просто не дойдёт. Нейросеть физически не сможет вас процитировать, потому что не будет держать вас перед глазами.
Как мы разбирали в тексте «Почему ИИ не видит ваш сайт», чаще всего компания выпадает именно на этом шаге — робот получает пустую страницу и добавить в базу нечего.
Продукты, которыми люди пользуются каждый день, устроены одинаково — просто вслух про RAG говорят редко.
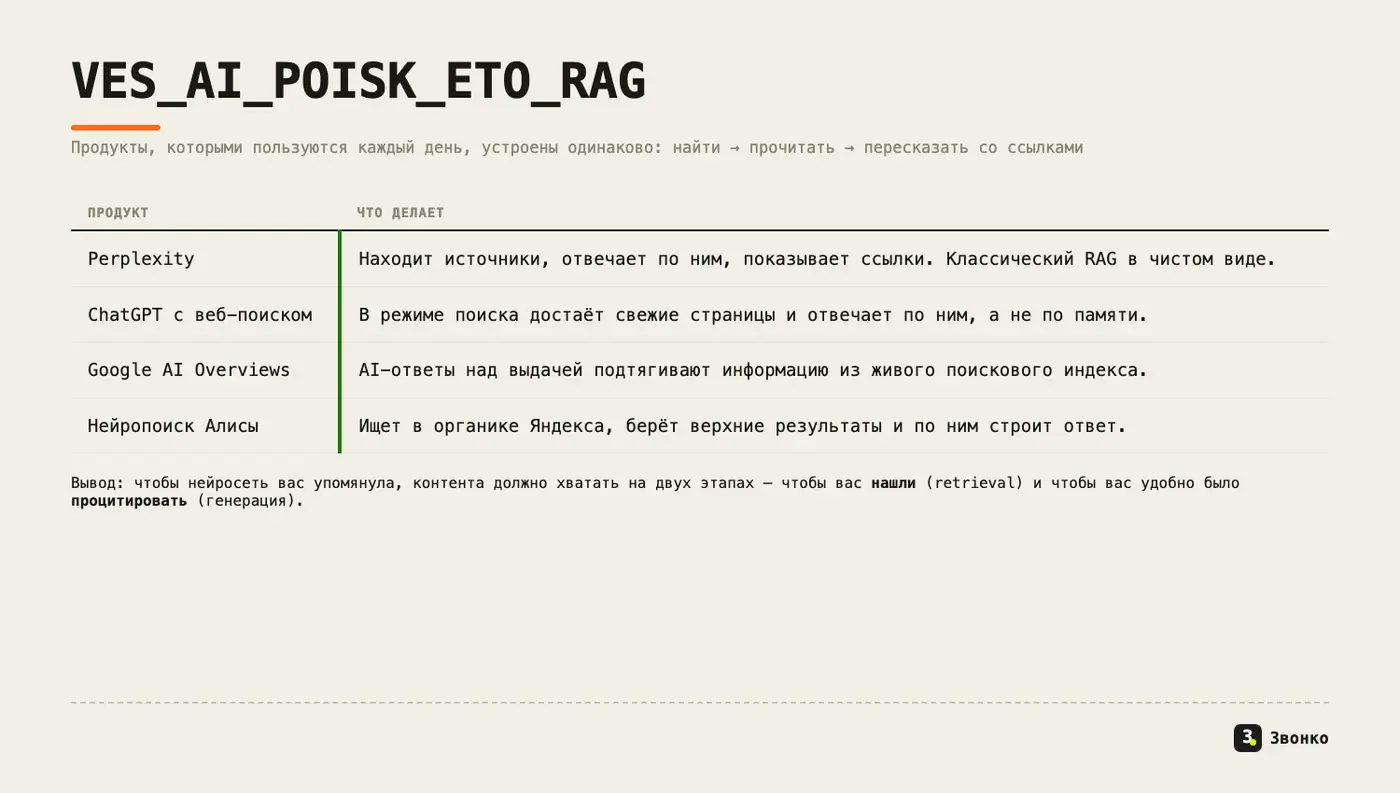
Чтобы нейросеть вас упомянула, вашего контента должно хватать сразу на двух этапах. Сначала — чтобы вас нашли на шаге retrieval (это про индексацию и релевантность). Потом — чтобы вас удобно было процитировать на шаге генерации (это про то, как написан сам текст). Оба этапа и закрывает продвижение бренда в нейросетях.
Оптимизацию под ИИ-ответы называют по-разному: AEO (Answer Engine Optimization), GEO (Generative Engine Optimization) — что за этим стоит на практике, разбирали в материале про GEO-оптимизацию и попадание в ответы ChatGPT, Perplexity и Яндекс AI. За модными аббревиатурами стоит ровно одна идея — подстроить сайт под то, как RAG вытаскивает и использует источники. Ahrefs в своём разборе RAG прямо связывает видимость в AI-поиске с попаданием в retrieval-этап: нет вас в извлекаемом корпусе — нет и в ответе.
Из механики RAG вытекают вполне конкретные требования к контенту.
Вас должно быть легко найти технически. Если страница отдаётся только после выполнения JavaScript, а робот получает пустой HTML, ваш текст может не попасть в индекс, из которого RAG достаёт документы. Чистый серверный HTML, открытый доступ для AI-краулеров, аккуратная структура — это входной билет.
Ответ на вопрос должен лежать на поверхности. RAG вытаскивает фрагменты, а не весь сайт целиком. Если прямой ответ спрятан в середине длинного абзаца, шанс, что именно этот кусок извлекут и процитируют, падает. Поэтому в текстах под нейросети работает приём «сначала ответ, потом детали»: чёткий тезис в первом предложении раздела, подзаголовки-утверждения, короткие самодостаточные блоки.
Факты нужно подкреплять. Модель охотнее цитирует куски с конкретикой — цифрами, датами, именами, ссылками на первоисточник. Абстрактная вода на шаге генерации проигрывает фрагменту, где есть за что зацепиться. По этой же логике хорошо заходят структурированные данные и понятная разметка: они помогают машине разобрать, что перед ней.
Свежесть имеет цену. Раз RAG на каждый запрос лезет за актуальными документами, устаревшая страница проигрывает обновлённой. Регулярное обновление помогает остаться в выдаче, из которой набирают контекст. Технический доступ при этом решает не меньше свежести: если робот не видит текст, обновляйте его сколько угодно — в контекст он не попадёт. Почему так выходит, разбирали в статье почему ИИ не видит ваш сайт.
Частый вопрос: если нужно, чтобы ИИ знал про мою компанию, может, проще дообучить модель на своих данных? Это другой подход, и для задачи видимости он почти всегда лишний.
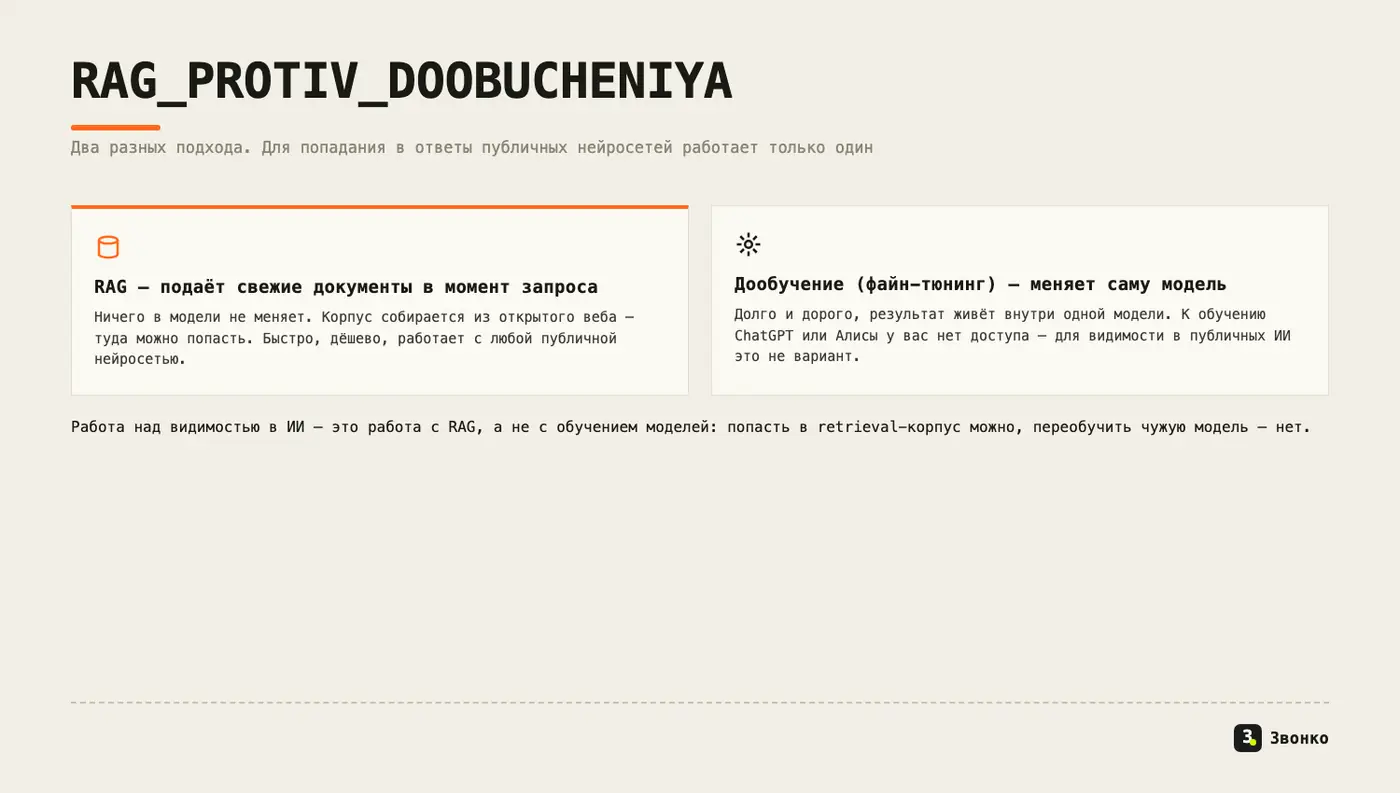
Дообучение (файн-тюнинг) меняет саму модель — долго, дорого, и результат живёт внутри одной конкретной модели. RAG ничего в модели не меняет: он просто подаёт свежие документы в момент запроса. Для бизнеса, который хочет попадать в ответы публичных нейросетей, файн-тюнинг вообще не вариант — вы не имеете доступа к обучению ChatGPT или Алисы. А вот в их retrieval-корпус попасть можно: он собирается из открытого веба — на этом и держится продвижение в ответах ChatGPT. Именно поэтому работа над видимостью в ИИ — это работа с RAG, а не с обучением моделей. IBM в своём объяснении формулирует так же: RAG даёт модели доступ к актуальным внешним знаниям без переобучения.
RAG звучит как термин для инженеров, но по сути это правила игры, по которым нейросети выбирают, кого показать пользователю. Понимаете механику — понимаете, за счёт чего одни компании попадают в ответы ИИ, а другие остаются невидимыми, хотя сайт у них вроде бы есть.
Нет. Нейросеть (языковая модель) — один из двух компонентов. RAG добавляет к ней модуль поиска по внешней базе, чтобы модель отвечала по свежим документам, а не только по памяти из обучения.
Снижает, но не гарантирует их отсутствие. Если в найденных источниках ошибка или модель неверно их истолкует, ответ всё равно может быть неточным. Поэтому хорошие системы показывают ссылки — чтобы можно было проверить.
Задайте нейропоискам (Perplexity, ChatGPT с поиском, Алисе) вопросы, по которым вас должны находить, и посмотрите, кого они цитируют. Регулярный такой замер показывает вашу реальную видимость в ИИ.
Он его не отменяет. Retrieval во многом опирается на те же сигналы — индексацию, релевантность, авторитет. Оптимизация под нейросети надстраивается над здоровым SEO, а не заменяет его.
Это хранилище, где документы лежат в виде числовых векторов-координат смысла. По ним система за миллисекунды находит фрагменты, близкие к запросу по смыслу, а не по точному совпадению слов.
Для внутренних задач (чат-бот по базе знаний, поиск по документам) — иногда да. Но чтобы попадать в ответы публичных нейросетей, свой RAG не нужен: работать надо над тем, чтобы ваш сайт находил и цитировал чужой RAG — тот, что стоит за Perplexity, ChatGPT и Алисой.
 GEO
llms.txt советуют GigaChat и ChatGPT, а Алиса AI, Google и Claude — нет. Что это за файл, пример, нужен ли он сайту и почему Google его не использует.
Читать статью → AEO
Трофей Яшина 2026: Сафонов из ПСЖ — первый россиянин среди десяти номинантов. Вручение 26 октября в Лондоне. Что ChatGPT, Google и Алиса AI думают о его шансах.
Читать статью → AEO
Спросили несколько нейросетей, где купить iPhone 18 Pro в России: Google зовёт в крупные сети, Алиса AI — в небольшие магазины, а ChatGPT перепутал страну и посоветовал Польшу.
Читать статью →Начнём с бесплатного экспресс-замера: покажем, как нейросети видят ваш бренд сейчас и где есть смысл работать.