Как ИИ выбирает источники: что доказано, а что миф
Нейросеть берёт источники в два этапа: сначала поиск собирает кандидатов, потом модель отбирает фрагменты. Что подтверждено документацией и данными, что миф.
Читать статью →Как бизнесу попасть в ответы нейросетей — Алисы AI, ChatGPT, Google AI Overviews: какие страницы ИИ берёт по этому вопросу (разбор 27 ответов), пять рычагов и как проверить результат.
Чтобы бизнесу попасть в ответы нейросетей, нужны страница с ответом на вопрос клиента в заголовке и первом абзаце, место этой страницы в первой десятке поиска и упоминания компании на площадках, которые нейросети цитируют.
Алиса AI, ChatGPT с поиском и Google AI Overviews читают то, что сами нашли в выдаче, поэтому страница вне первой десятки для них не существует. Результат проверяется только замером — долей контрольных вопросов, где нейросеть называет компанию без подсказки. Гарантии, что конкретный ответ назовёт бренд, нет: ответ каждый раз собирается заново.
Мы в Звонко дважды задали этот вопрос нейросетям с поиском — 17 и 22 августа 2026 года, среди них Алиса AI, ChatGPT, Google AI Overviews и Perplexity. Получилось 27 ответов, в 20 из них модель показала источники. Всего процитировано 56 страниц. Девять из них — справки самих платформ (OpenAI, Google, Яндекса), остальные 47 — статьи.
У 30 статей из 47 вопрос почти дословно стоит в адресе и заголовке: «как бизнесу попасть в ответы нейросетей», «как попасть в ответы ИИ», «как бренду попасть в выдачу нейросети». Нейросеть с поиском отправляет в поисковик короткий запрос, близкий к вопросу пользователя, и читает найденное. Страница, озаглавленная под другой вопрос, в этот круг не попадает, даже если внутри написано то же самое.
Второй фильтр — обычная выдача. 22 августа в первой десятке Яндекса по этому вопросу семь мест из десяти заняли блоги компаний на двух площадках: четыре статьи на РБК Компаниях и три на Т-Банк Секретах. В первой восьмёрке Google — Forbes, Т-Банк Секреты, vc.ru и ppc.world. По исследованию «Ашманова и партнёров» «Коммерческий поиск с Алисой» (2026), Алиса AI отбирает источники из верха органической выдачи Яндекса, и после пятой позиции шансы страницы резко падают. В нашем замере 22 августа четыре из девяти источников Алисы по этому вопросу стояли в первой десятке по тому же запросу; остальные она нашла по своим уточняющим запросам, которые тоже ищут в обычной выдаче. У ChatGPT и Perplexity связь с выдачей слабее, они охотнее берут vc.ru и блоги компаний.
Эту страницу мы проверили тем же способом. В 27 ответах её не было ни разу, в первой десятке Яндекса и Google — тоже. Причин две, обе видны по списку выше: заголовок отвечал на вопрос про одну нейросеть, ChatGPT, а первый абзац начинался с методики замера, а не с ответа. Эта версия переписана под вопрос бизнеса: ответ стоит в первом абзаце, подзаголовки повторяют формулировки, которыми клиенты спрашивают.
Клиенты в первую очередь спрашивают: «когда мы окажемся в топе ответов ChatGPT?». Вопрос звучит как про позицию в поисковой выдаче, но механика другая, и в такой форме ответа у него нет.
ChatGPT не строит рейтинг сайтов. На каждый запрос модель заново собирает текст ответа, и один и тот же вопрос может выдать разные бренды в разном порядке даже в течение одного дня. Я видел это на своих же замерах: из 20 одинаковых промптов, повторённых через неделю, три поменяли набор упомянутых брендов без единого изменения на сайтах клиентов.
Отсюда вывод для этой статьи: считать нужно долю упоминаний. Сколько раз из N контрольных запросов бренд появился в ответе — вот метрика, вокруг которой построен весь план ниже. Место в перечислении вторично. Дальше — откуда модель вообще берёт бренды, потом пять рычагов, на которые можно влиять, и как проверить, что рычаги сработали.
ChatGPT, Алиса AI и другие нейросети с поиском формируют ответ из двух источников: параметрических знаний (то, что модель выучила при обучении, с датой отсечки) и веб-контекста через встроенный поиск по свежим запросам. Для брендового вопроса модель либо вспоминает то, что уже усвоила из обучающих данных, либо на лету читает несколько страниц из выдачи и компонует ответ из их фрагментов.
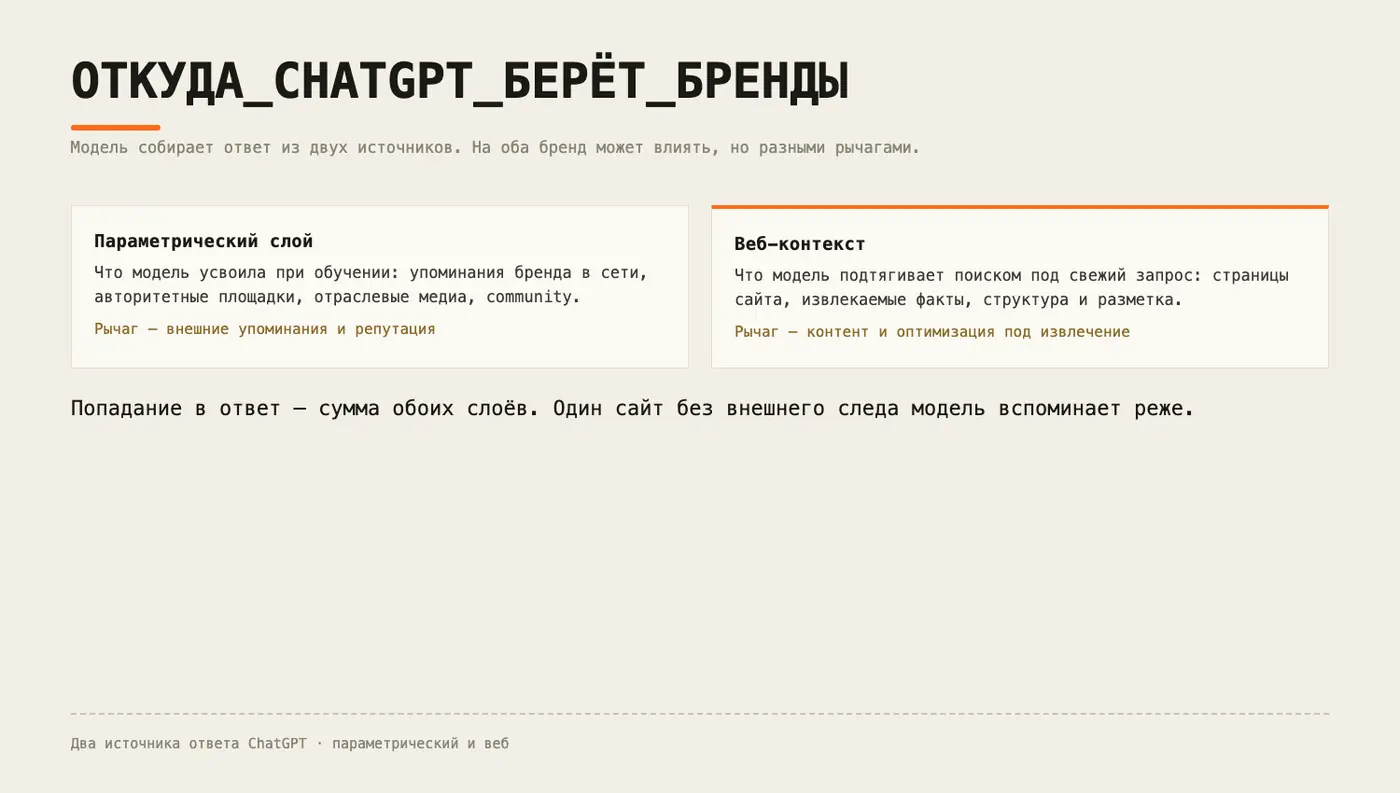
Параметрический слой формируется на этапе обучения модели и зависит от того, сколько раз бренд упоминался в текстах, которые попали в обучающий корпус: Wikipedia, крупные медиа, отраслевые обзоры, форумы. Обновляется этот слой редко — только со следующей версией модели.
Поэтому и вопрос, как попасть в ответы ChatGPT, решается теми же рычагами, что и для Алисы AI: у всех нейросетей с поиском работает веб-контекст. Веб-контекст работает иначе. При запросе с browsing или SearchGPT модель отправляет обычный поисковый запрос, получает список страниц и вытаскивает из них конкретные фрагменты — предложения и абзацы, которые прямо отвечают на вопрос. Здесь скорость обновления другая: новая страница может попасть в ответ модели за недели, тогда как параметрический слой обновляется годами. По исследованию Princeton, Georgia Tech и IIT Delhi 2024 года (arXiv 2311.09735), контент, оптимизированный под извлечение (прямой ответ, факты, цитаты, статистика), получает на 30–115% больше упоминаний в таких ИИ-ответах против неоптимизированного текста на ту же тему.
Отсюда практический вывод: у бренда два разных фронта работы с разной скоростью отдачи. Веб-контекст — то, на что можно влиять контентом здесь и сейчас. Параметрический слой растёт медленно, через внешние упоминания на площадках, которые модель уже читает при обучении. Похожий принцип двух слоёв Google описывает для собственных AI Overviews: ответ ИИ-модели надстраивается над обычной поисковой выдачей, опираясь на неё.
Продвижение бизнеса в нейросетях начинается с базового замера: составьте 15–20 вопросов, которые реальный клиент задал бы без упоминания бренда, задайте их в ChatGPT с включённым поиском и в Алисе AI и посчитайте долю ответов, где бренд назван. Это и есть Share of Model — точка отсчёта, без которой любой разговор о результате остаётся спором о впечатлениях.
Вопросы формулируйте так, как их задал бы клиент: «какой сервис аналитики выбрать для интернет-магазина», «кто делает контент-завод под ключ», «сравни агентства GEO-продвижения». Задайте их в ChatGPT с включённым поиском — версия без доступа к вебу покажет только память модели с датой отсечки и занизит реальную картину для молодых и растущих брендов.
По каждому ответу отметьте три вещи:
Посчитайте долю: сколько запросов из 20 упомянули бренд. Это и есть базовая метрика Share of Model — из нашей практики в Звонко именно с неё начинается любой аудит видимости, потому что без базового числа непонятно, что вообще считать ростом.
Отдельно зафиксируйте формулировки конкурентов — какие фразы и цифры модель берёт из их текстов. Это подсказка, какие фрагменты извлекаемы, а какие модель игнорирует даже у сильных игроков рынка.
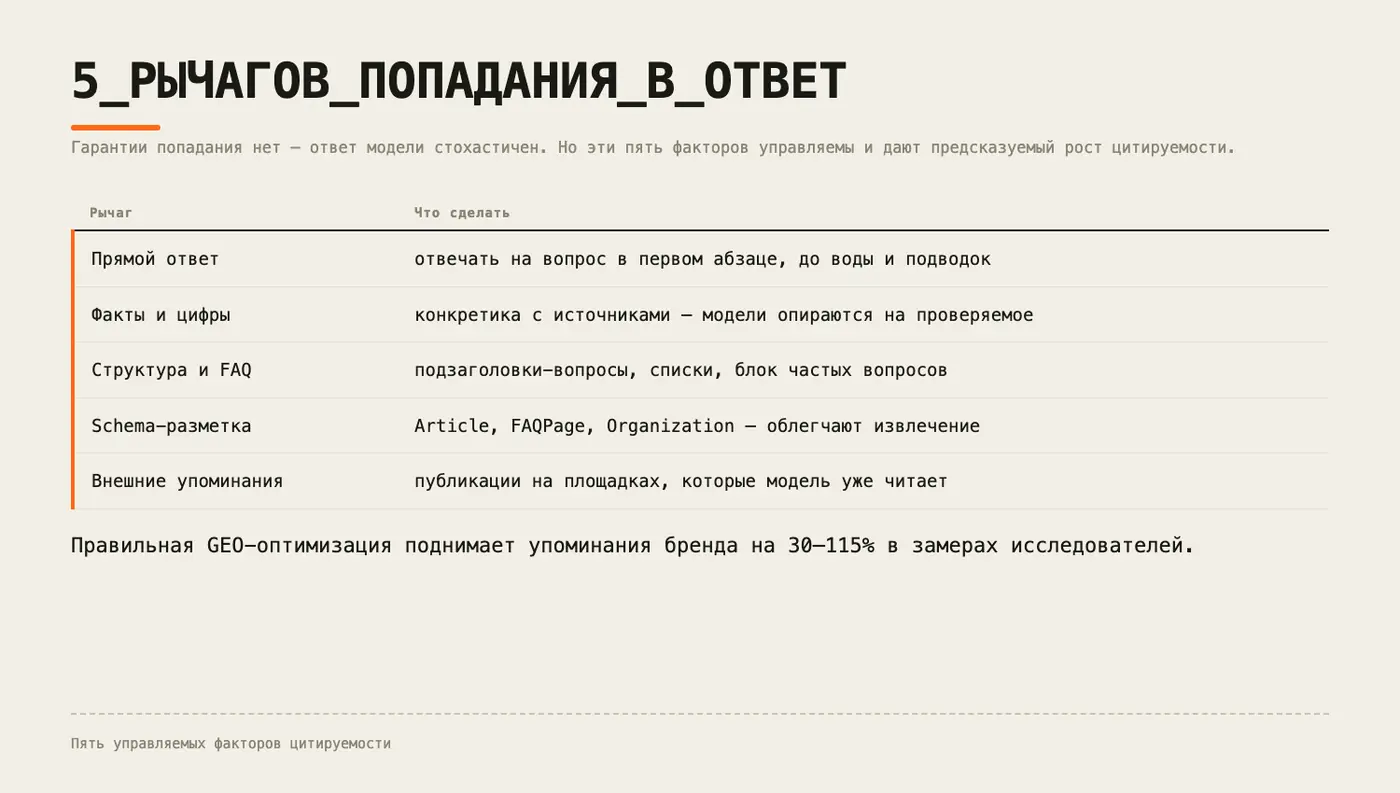
Гарантированного попадания нет ни у одного из пяти пунктов ниже. Но каждый напрямую повышает шанс, что модель извлечёт именно ваш фрагмент текста, — и это управляемо, в отличие от самого результата.
1. Прямой ответ в первых предложениях. Каждый смысловой блок открывается готовым ответом на вопрос, без подводки к нему. Модель извлекает фрагменты целиком, и если ответ спрятан в третьем абзаце, шанс на цитирование падает.
Грабли: на одном проекте первый абзац открывался историей компании — «работаем с 2019 года, помогли сотне клиентов». Модель его игнорировала: абзац не отвечал ни на один реальный запрос пользователя. Переписали на прямое определение услуги в первом предложении — страница начала цитироваться по контрольным промптам уже на следующем замере.
2. Факты и цифры вместо общих фраз. «Экономит время» не извлекается как факт, «сокращает обработку заявки с 3 дней до 4 часов» — извлекается. Каждый факт идёт с источником: датой замера, конкретным числом, ссылкой на исследование.
Грабли: у клиента в нише B2B-услуг весь сайт держался на оценочных формулировках без единой цифры про подход и команду. Дописали конкретику — сроки в днях, объёмы в штуках, стоимость по тарифам. Цифры мы в Звонко всегда сверяем с реальными данными клиента: выдуманная статистика в этом контуре обнуляет доверие быстрее, чем помогает.
3. Структура из вопросов и списков. H2 в форме вопроса («Сколько стоит…», «Как проверить…») совпадает по форме с самим запросом пользователя, что облегчает модели сопоставление. Списки и таблицы извлекаются проще сплошного текста абзацами по 500 слов.
Грабли: FAQ ради галочки — вопросы, которые никто не задаёт, с ответами в одну строку — не цитируется. Модель берёт FAQ с ответом на 50–150 слов и контекстом внутри; голую фразу пропускает. Проверяли на живых промптах: короткие формальные блоки не всплывали ни разу. То же с заголовками: по разбору выше нейросети берут страницы, где заголовок повторяет вопрос клиента, а не придуманную автором формулировку.
4. Schema-разметка. FAQPage, Article, HowTo из справочника Schema.org — явные метки для модели, где вопрос, а где ответ, без необходимости разбирать текст самостоятельно. Рекомендации Google по структурированным данным описывают тот же принцип для поисковой выдачи. Какие типы разметки влияют сильнее, мы разбирали отдельно — микроразметка для нейросетей. Разметка не подменяет содержание, но снижает шанс, что модель неверно распознает структуру страницы.
Грабли: один сайт был размечен идеально, но вопросы в schema расходились с текстом на странице. Несовпадение снижает доверие к источнику при автоматической проверке — разметка без реального контента под ней не работает.
5. Внешние упоминания на площадках, которые модель уже читает. Список источников, откуда крупные модели чаще всего берут обучающие тексты, годами обсуждается в исследованиях датасетов Common Crawl — крупнейшего открытого веб-архива, на выборках из которого тренируют большинство языковых моделей. Отраслевые медиа, Wikipedia, крупные community формируют параметрический слой. Для веб-контекста в рунете работают блоги компаний на vc.ru, РБК Компаниях и Т-Банк Секретах: по нашему разбору они держат большую часть первой десятки Яндекса по вопросам о продвижении в нейросетях. Одна публикация на авторитетной площадке даёт больше веса, чем десять на низкочастотных ресурсах: вероятность попадания именно этой страницы в обучающий корпус выше.
Грабли: разовый пресс-релиз на непрофильной площадке почти не даёт эффекта. Мы в Звонко берём 3–5 изданий в нише, которые уже цитируются в ответах моделей, и работаем туда системно, вместо того чтобы размазывать усилия по всем подряд.
Каждый рычаг проверяется отдельно: после публикации оптимизированного текста смотрите, появился ли он в выдаче ChatGPT по своему же ключевому вопросу через 2–3 недели. Если нет — проверяйте пункты 1–3 первыми, они самые быстрые в правке. Все пять рычагов вместе мы собираем в работу по продвижению в ChatGPT и другие нейросети.
Мониторинг упоминаний в ChatGPT, Алисе AI и других нейросетях — это повтор того же набора из 15–20 запросов через 4–6 недель после изменений — те же формулировки, что и в базовом замере, иначе сравнение некорректно. Как провести такой замер руками, ничего не покупая, расписано в протоколе на 15 минут. Разница в доле упоминаний (Share of Model) — главный показатель эффекта.
Смотрите не только на факт упоминания, но и на контекст: модель стала называть бренд первым в перечислении или последним, добавила конкретное описание услуги или ограничилась общей фразой. Это качественный слой поверх количественного.
Отдельно проверяйте, какие конкретно фрагменты текста цитирует модель дословно или близко к тексту — часто это ровно те абзацы, где переписан пункт 1 или 2 из списка рычагов выше. Такое совпадение подтверждает, какой из рычагов сработал именно для этой страницы, и подсказывает, что усиливать на следующей.
Первая десятка выдачи — условие, а не гарантия. Топ-1 в Google не гарантирует попадание в ChatGPT: механики разные. Google ранжирует страницу целиком как единый URL по ключевому запросу, ChatGPT извлекает отдельные фрагменты как самостоятельные смысловые единицы. Проверять нужно оба канала отдельно, не полагаясь на позицию в органике как на прокси для видимости в ИИ-ответах.
Ответ ChatGPT формируется заново на каждый запрос, и один и тот же вопрос через час может дать другой набор брендов без единого изменения на сайте. Это делает бессмысленным обещание «попадёте в ответ к такому-то числу» — обещать можно рост доли упоминаний, но не единичный результат.
Веб-контекст реагирует на изменения относительно быстро: 4–8 недель на заметный сдвиг доли упоминаний по свежим запросам, если контент и внешние упоминания системно приведены под извлекаемость. Параметрический слой обновляется циклами обучения моделей — точных сроков тут никто не назовёт, включая саму OpenAI: страница OpenAI про поиск описывает механику browsing, но не даёт таймингов индексации.
Для контекста масштаба: по данным Ahrefs, ChatGPT приносит сайтам около 0,19% реферального трафика против 42% у Google, но конверсия визита из ChatGPT выше — около 7,1% против типичных значений органики, то есть один визит из ChatGPT в среднем ценнее в 4,4 раза. Видимость в ChatGPT — это про качество контакта с уже заинтересованным человеком, который прочитал развёрнутый ответ, прежде чем зайти на сайт.
В нашей практике в Звонко мы не гарантируем попадание. Мы замеряем сейчас, работаем над рычагами, замеряем через 4–6 недель и показываем дельту. Для системы, которая каждый раз собирает ответ заново, другой проверяемой отчётности нет.
Что почитать дальше по теме: как устроена GEO-оптимизация целиком — что такое GEO-оптимизация и зачем она сайту; чем GEO принципиально отличается от классического SEO — GEO или SEO для нейросетей.
Хотите увидеть свою текущую долю упоминаний в ChatGPT, Алисе AI и Гигачате от Сбера в конкретном числе — оставьте заявку на бесплатный аудит AI-видимости. Прогоняем 20 запросов из вашей ниши через 6 платформ и присылаем таблицу с текущим Share of Model, до того как что-то менять на сайте. А как устроена сама услуга — на странице продвижение в нейросетях (GEO/AEO); или начните с главной, там короче про то, что мы делаем в Звонко в целом.
Нужна страница, которая отвечает ровно на вопрос клиента в заголовке и первом абзаце, стоит в первой десятке обычной поисковой выдачи и подкреплена упоминаниями компании на площадках, которые нейросети уже читают: vc.ru, блоги компаний на РБК и Т-Банк Секретах, отраслевые медиа. Нейросеть с поиском сначала ищет, потом читает найденное: страницу вне выдачи она не увидит. Результат проверяют замером — долей контрольных вопросов, в ответах на которые компания названа.
Чаще всего статья отвечает на соседний вопрос. В наших замерах 17 и 22 августа 2026 года нейросети на вопрос «как бизнесу попасть в ответы нейросетей» опирались на 47 статей, и у 30 из них этот вопрос почти дословно стоял в адресе и заголовке. Статья, озаглавленная под одну нейросеть или начинающаяся с методики замера, по такому вопросу не находится.
Веб-контекст обновляется быстрее параметрического слоя: заметный сдвиг в цитируемости по свежим запросам возможен за 4–8 недель после публикации оптимизированного контента и внешних упоминаний. Попадание в обучающие данные модели идёт месяцами и зависит от следующего цикла обучения — тут сроков никто не назовёт точно.
Нет. Ответ модели стохастичен: один и тот же запрос в разное время выдаёт разные формулировки и разный набор брендов. Управлять можно факторами — структурой контента, фактурой, внешними упоминаниями, — но не самим результатом каждого конкретного ответа.
Позиция в перечислении вторична. Первична доля ответов с упоминанием бренда от общего числа заданных запросов (Share of Model). Если из 20 контрольных промптов бренд звучит в 6, это 30% — конкретное число, с которым можно работать и сравнивать себя с прошлым замером.
Нет. Механики разные: поисковая выдача ранжирует страницу целиком по ключевому запросу, а ChatGPT извлекает и цитирует отдельные фрагменты текста, которые отвечают на вопрос напрямую. Страница на первом месте в Google может не попасть в ответ ChatGPT, если её текст неудобен для извлечения.
Составьте 15–20 вопросов, которые реальный клиент задал бы без упоминания бренда, и задайте их ChatGPT вручную (версия с доступом к поиску). Отметьте в таблице, где бренд назван, где — только конкуренты, где — никто. Повторяйте раз в 4–6 недель на тех же формулировках, чтобы видеть динамику, а не разовый снимок.
Да. Ранжирование в органике и извлекаемость для ИИ-ответа — разные задачи. Schema (FAQPage, Article, HowTo) явно размечает структуру для модели, которая разбирает страницу на фрагменты, а не читает её целиком, как человек. Хорошая позиция в Google не заменяет разметку.
 GEO
Нейросеть берёт источники в два этапа: сначала поиск собирает кандидатов, потом модель отбирает фрагменты. Что подтверждено документацией и данными, что миф.
Читать статью → GEO
Генеративный поиск надстроен над индексом: вопрос дробится на подзапросы, система отбирает фрагменты страниц и пересказывает их. Как это устроено у Google, Алисы AI, ChatGPT и что делать сайту.
Читать статью → репутация в ИИ
Негатив в ответах нейросетей не удалить кнопкой: он уходит вместе с источником. Замер Звонко на 20 компаниях: шесть типов негатива и что делать с каждым.
Читать статью →Начнём с бесплатного экспресс-замера: покажем, как нейросети видят ваш бренд сейчас и где есть смысл работать.