llms.txt советуют GigaChat и ChatGPT, а Алиса — ни разу
llms.txt советуют GigaChat и ChatGPT, а Алиса AI, Google и Claude — нет. Что это за файл, пример, нужен ли он сайту и почему Google его не использует.
Читать статью →Как разместить llms.txt на сайте под Tilda и 1С-Битрикс, что писать внутри по спецификации и как за одну команду проверить, что файл отдаётся, а не страница ошибки.
Коротко: llms.txt — текстовая карта сайта для языковых моделей, которую кладут в корень домена. На Tilda её грузят через раздел корневых файлов и публикуют сайт, на Битриксе — кладут рядом с index.php и проверяют, что маршрутизатор не перехватил адрес. Спроса от ботов пока почти нет, но установка стоит пятнадцати минут.
Спецификация llmstxt.org описывает обычный Markdown с жёстким порядком элементов:
# Название компании

> Одно предложение о том, чем занимается компания и для кого.

## Услуги

- [Название услуги](https://example.ru/service): что входит и кому подходит
- [Вторая услуга](https://example.ru/service-2): краткое пояснение

## Материалы

- [Статья](https://example.ru/blog/article): о чём и чем полезна
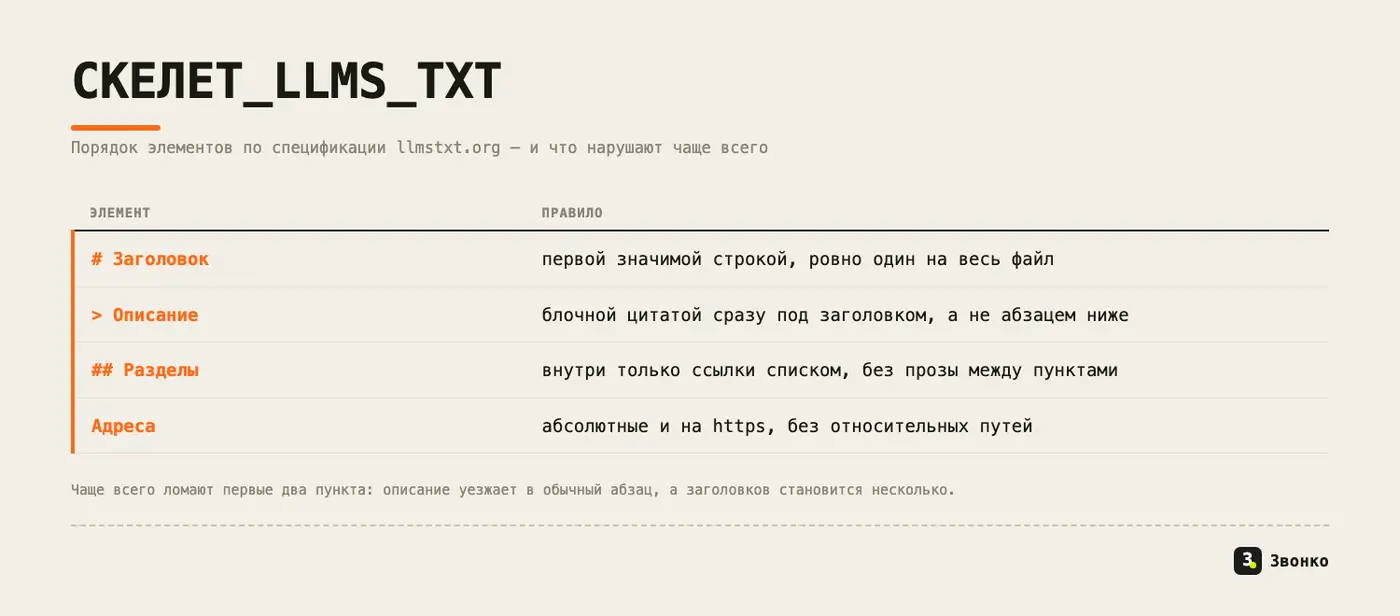 Первые два пункта ломают чаще остальных.
Четыре правила, которые нарушаются в большинстве файлов:
https://.Собрать и проверить файл по этим правилам можно нашим бесплатным генератором и валидатором llms.txt — он же покажет ошибки порядка.
В Тильде нет прямого доступа к корневой папке, поэтому файл в корень сайта добавляют штатным механизмом публикации служебных файлов (справка Tilda).
robots.txt и файлов подтверждения прав).llms.txt как обычный файл.https://ваш-домен/llms.txt.Если у сайта подключён собственный домен, файл отдаётся с него. На поддомене конструктора адрес будет соответствующий, и для моделей он ценности почти не имеет.
Здесь корень доступен, но мешает обработка запросов через маршрутизатор (документация разработчика).
llms.txt в корень публичной части — рядом с index.php и robots.txt..htaccess или конфигурацию nginx: правила, направляющие все запросы в bitrix/urlrewrite.php, могут перехватить и этот адрес. Файл должен отдаваться напрямую, до маршрутизации.Для многосайтовой конфигурации файл кладётся в корень каждого сайта отдельно — общий не подхватится.
Одна команда показывает всё существенное (мануал curl):
curl -I https://example.ru/llms.txt
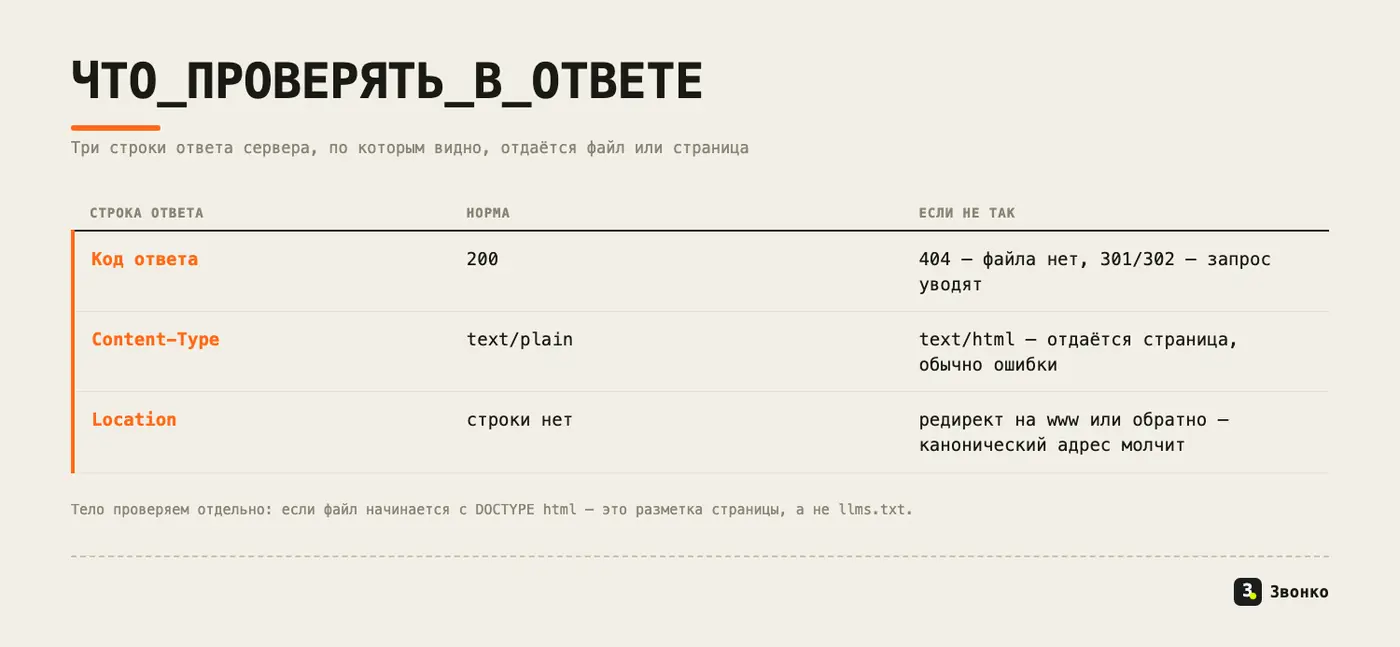 Тело файла смотрим отдельно — начало с DOCTYPE выдаёт страницу вместо файла.
В ответе смотрим три вещи:
200. Код 404 означает, что файла нет по адресу, 301 или 302 — что запрос уводят на другую страницу.Content-Type: text/plain. Если отдаётся text/html, значит вместо файла показывается страница сайта, чаще всего страница ошибки. Что означают эти значения — в справочнике MDN.www или без. Модель пойдёт по каноническому адресу, и он должен отвечать сам.Содержимое проверяется отдельно:
curl -s https://example.ru/llms.txt | head -20
Если в начале видно <!DOCTYPE html> — сервер отдаёт разметку страницы, а не файл.
Поставили файл, а нейросети всё равно вас не называют?
Обсудить с Звонко →Прямого спроса со стороны ботов сейчас нет: по данным Limy.ai на 515 миллионов событий ИИ-ботов за 90 дней пришлось 408 запросов файла. Яндекс поддержку llms.txt не заявлял, и Алиса AI собирает ответ из органической выдачи, а не из служебного файла; та же логика действует и при попадании в ответы ChatGPT.
Разумная позиция: файл ставится как дешёвая страховка на будущее — пятнадцать минут работы и ноль поддержки. Рассчитывать на рост упоминаний в нейросетях от него не стоит: туда ведут позиции в поиске и структура самих страниц — этим и занимается продвижение в нейросетях (GEO/AEO). Для сравнения: правила доступа роботов из robots.txt поисковые системы читают гарантированно, и вот их стоит держать в порядке в первую очередь.
Что делать вместо этого, разобрано в материалах про техническую доступность сайта для ИИ, архитектуру сайта под ИИ-поиск и самостоятельную проверку видимости за 15 минут.
На Tilda файл грузится через раздел корневых файлов и требует публикации сайта, на Битриксе — кладётся в корень и проверяется на перехват маршрутизатором. После установки обязателен curl -I: код 200, тип text/plain, без редиректов. Содержание — четыре правила спецификации, из которых чаще всего нарушают порядок заголовка и описания.
Это три разных файла с разными задачами: robots.txt управляет доступом роботов, карта сайта перечисляет адреса для обхода, llms.txt описывает ресурс словами для языковой модели. Первые два обязательны, третий — по желанию.
Нет. Полный текстовый слепок сайта имеет смысл для документации, которую читают агенты разработчика. Для корпоративного сайта это избыточно.
При изменении структуры разделов или состава услуг. Автоматизировать обновление стоит только там, где карта сайта меняется чаще раза в месяц.
Может, если в нём неработающие адреса или устаревшее описание. Файл с ошибками хуже отсутствующего: он утверждает неверное.
Конструктор отдаёт файлы из корня только после публикации сайта целиком. Пока сайт не опубликован заново, по адресу будет 404.
Запрос перехватывает маршрутизатор. Проверьте правила в .htaccess или конфигурации nginx, которые направляют всё в bitrix/urlrewrite.php, и исключите из них путь к файлу.
 GEO
llms.txt советуют GigaChat и ChatGPT, а Алиса AI, Google и Claude — нет. Что это за файл, пример, нужен ли он сайту и почему Google его не использует.
Читать статью → GEO
llms-full.txt — весь текст сайта одним файлом. Скачали его с 32 доменов и посчитали вес: медиана 716 тысяч токенов. Кому файл нужен, а кому хватит llms.txt.
Читать статью → AEO
Разбираем AEO и GEO по первоисточникам: где методы пересекаются, почему одного упоминания в ИИ мало и как согласовать проверяемый результат.
Читать статью →Начнём с бесплатного экспресс-замера: покажем, как нейросети видят ваш бренд сейчас и где есть смысл работать.