llms.txt советуют GigaChat и ChatGPT, а Алиса — ни разу
llms.txt советуют GigaChat и ChatGPT, а Алиса AI, Google и Claude — нет. Что это за файл, пример, нужен ли он сайту и почему Google его не использует.
Читать статью →llms-full.txt — весь текст сайта одним файлом. Скачали его с 32 доменов и посчитали вес: медиана 716 тысяч токенов. Кому файл нужен, а кому хватит llms.txt.
Коротко: llms-full.txt — весь текст сайта одним файлом, тогда как llms.txt только оглавление со ссылками. В спецификации второго файла нет. Мы в Звонко скачали его с 32 доменов: медиана 716 тысяч токенов, за один раз столько не читает ни одна модель. Сайту услуг он не нужен.
Автор: Игорь Новиков, сооснователь Звонко. Обновлено: 2 сентября 2026.
Запрос «llms full txt» в Яндексе за месяц набрал 189 показов против 40–49 в июле — спрос вырос вчетверо. Люди ставят llms.txt по инструкции, видят в чужих корнях второй файл и пытаются понять, обязателен ли он. Дальше — замер вместо пересказа: 2 сентября мы скачали оба файла с 32 доменов и посчитали их вес в байтах и токенах.
llms.txt устроен как оглавление: заголовок первого уровня с названием сайта, блочная цитата с описанием и списки ссылок с короткими пояснениями. Модель читает его целиком и понимает, куда идти дальше. Размер здесь принципиален — файл обязан помещаться в контекст вместе с вопросом пользователя и остальными материалами.
llms-full.txt устроен наоборот. В него сваливается содержимое всех страниц сайта подряд: заголовок, адрес, описание и полный текст в разметке Markdown. По описанию Mintlify, платформа собирает такой файл автоматически и держит его рядом с оглавлением, а лимит в 100 тысяч знаков, который действует для индекса, на полный слепок не распространяется.
Разница в назначении, а не в объёме. Оглавление показывает состав сайта и адреса, слепок выдаёт содержимое разом. Первый сценарий работает в диалоге, где модель подтягивает одну-две нужные страницы. Второй работает в кодовом агенте, которому проще один раз забрать документацию и искать по ней локально.
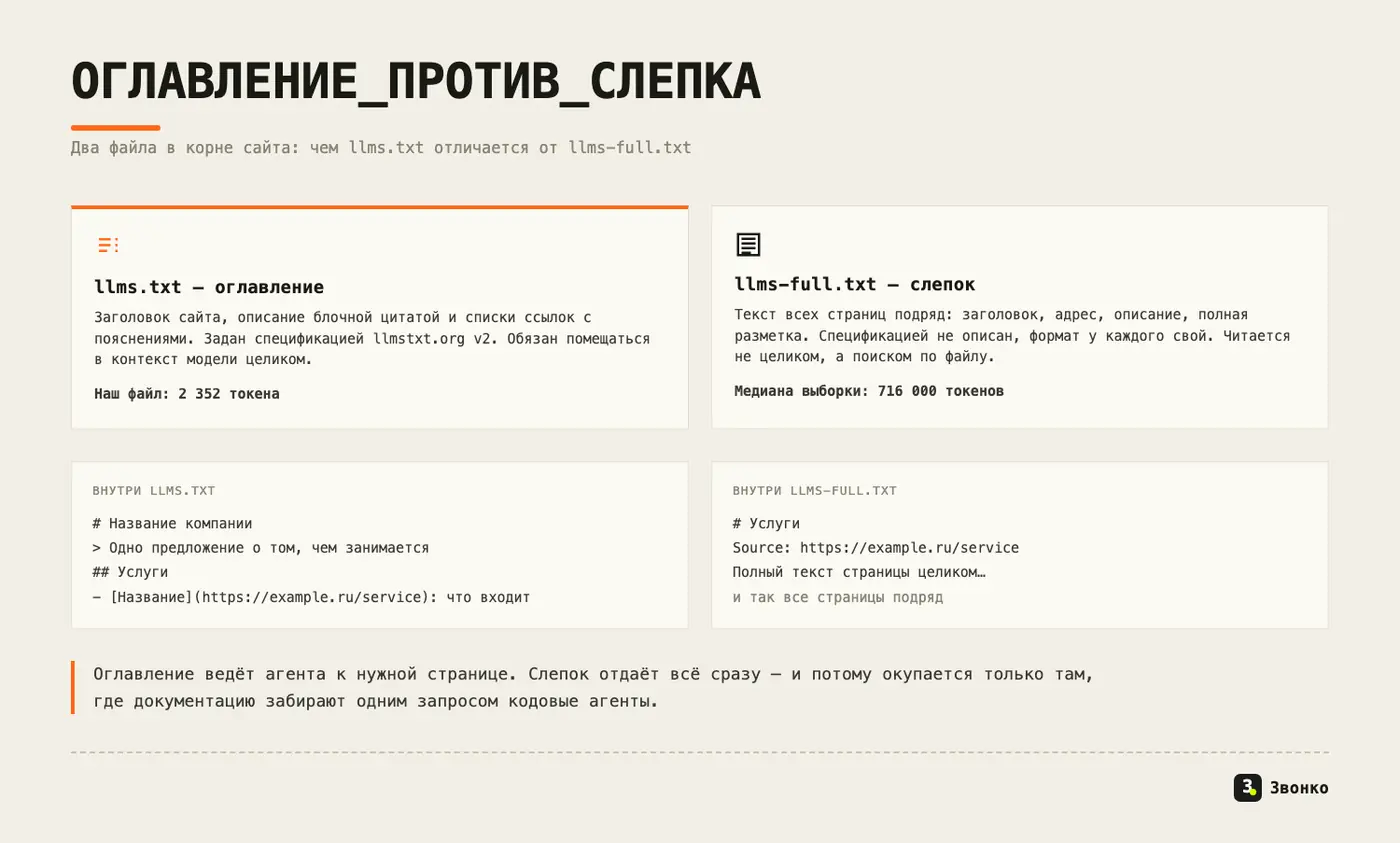 Два файла решают разные задачи, поэтому и живут по разным правилам.
Нет. Спецификация на llmstxt.org, обновлённая до второй версии 10 августа 2026 года, описывает один файл — llms.txt, и имя llms-full.txt в её тексте не встречается ни разу. Джереми Ховард формулирует прямо противоположный принцип: сам файл остаётся достаточно маленьким, чтобы влезть в контекст, а подробности лежат за ссылками и подгружаются по мере надобности.
Вторая версия ушла от идеи полного слепка ещё дальше. Страница изменений сообщает, что из предложения убрали инструмент llms_txt2ctx, который разворачивал файл в готовый контекст для модели, и вместе с ним пропал служебный смысл секции Optional. Вместо сборки одного большого куска стандарт закрепил другое поведение: агент просматривает или ищет по llms.txt, а затем идёт по нужным ссылкам.
Заодно v2 предложила механику, которая закрывает исходную боль без второго файла: у каждой страницы появляется Markdown-версия по тому же адресу с расширением .md, а найти её помогают заголовки Link с отношениями rel="alternate" и rel="describedby".
Показателен и сам сайт стандарта. llms.txt там лежит, весит 637 байт и содержит 156 токенов. Полного слепка нет.
Мы взяли 32 домена: документацию ИИ-лабораторий, платформы для разработчиков и российские сервисы. С каждого скачали llms.txt и llms-full.txt, отбросили ответы с HTML вместо файла и посчитали токены токенизатором o200k_base из библиотеки tiktoken. Оглавление отдают 23 домена, полный слепок — 19.
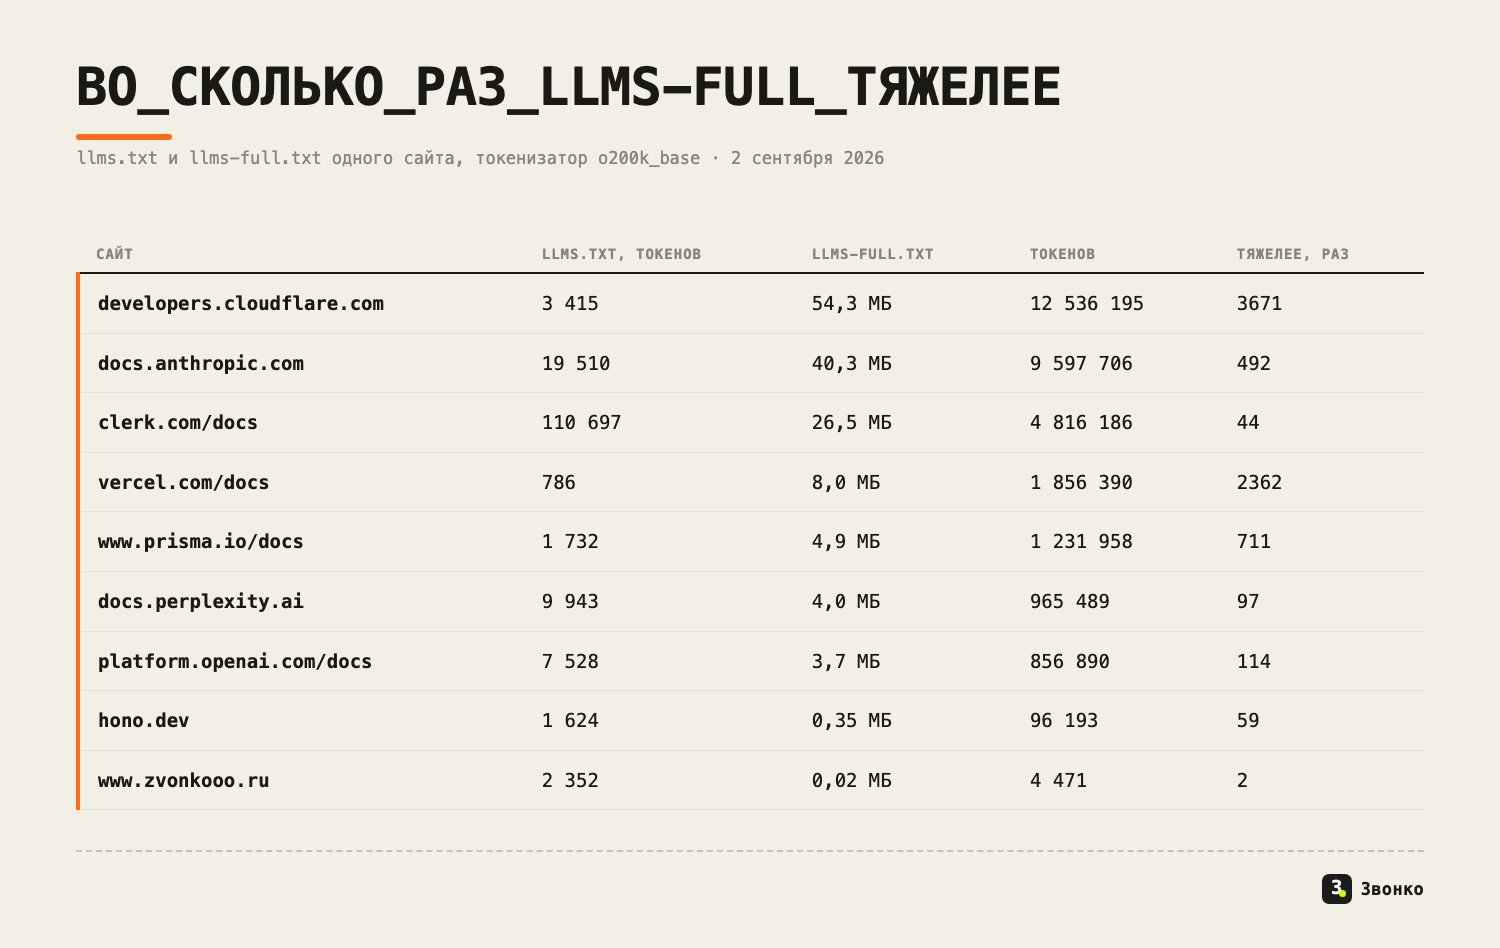 llms.txt и llms-full.txt одного сайта: токены, размер, во сколько раз тяжелее.
Медиана по шестнадцати чужим слепкам — 716 тысяч токенов, разрыв с оглавлением того же сайта в среднем девяностократный. Рекорд у документации Cloudflare: 54 МБ и 12,54 млн токенов.
Сопоставьте это с окном модели. У Claude оно составляет 200 тысяч токенов, по данным документации Anthropic, миллион доступен в бете; у GPT-5 по документации OpenAI — 400 тысяч. Файл Cloudflare больше самого просторного окна в двенадцать раз. Прочитать его целиком не может никто, и задумывался он не для этого: такой слепок скачивают, режут на куски и ищут по нему поиском.
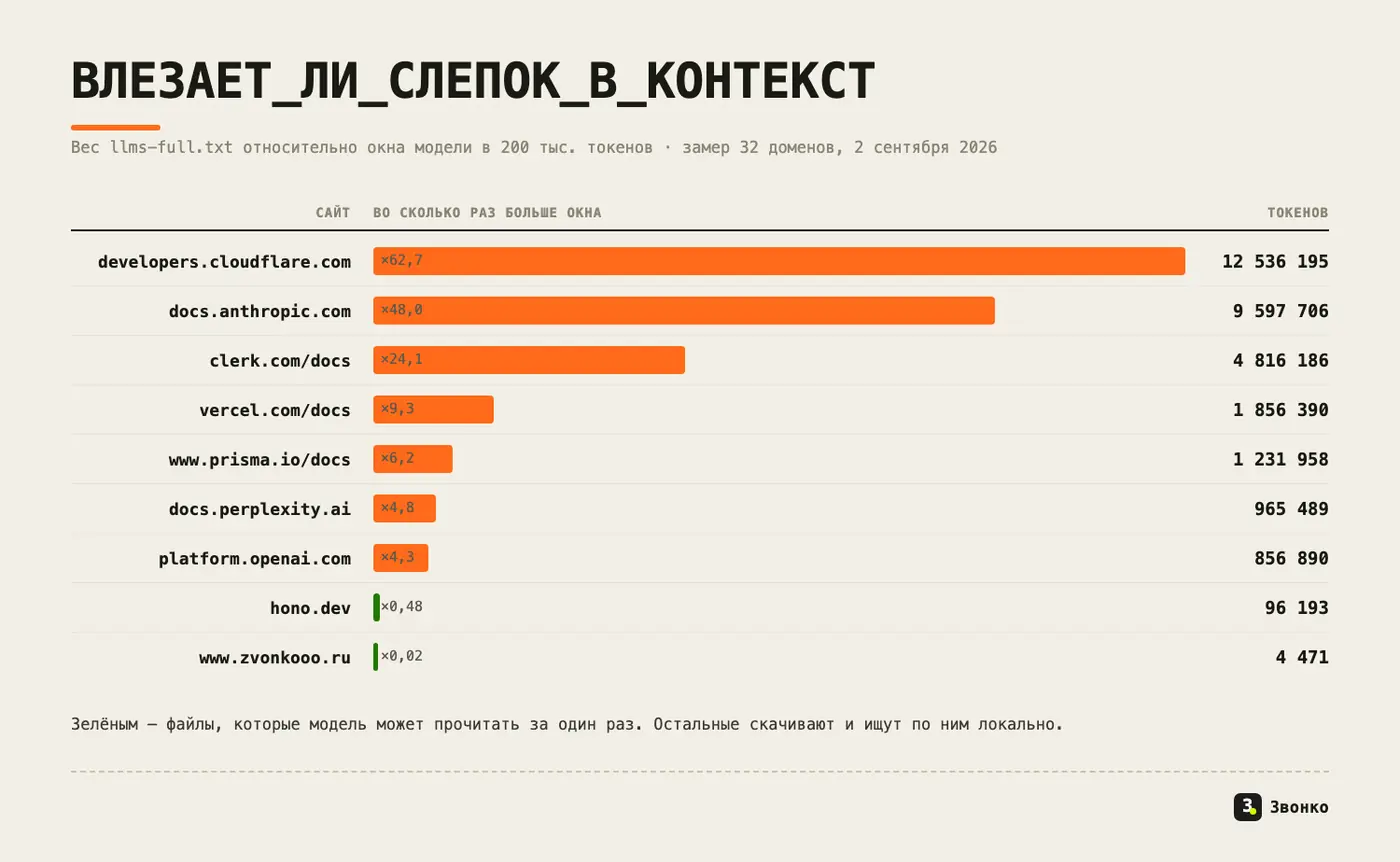 Замер 2 сентября 2026, токенизатор o200k_base.
Список тех, кто отдаёт настоящий полный слепок, читается однообразно: Cloudflare, Anthropic, OpenAI, Perplexity, Mistral, Vercel, Prisma, Clerk, Railway, Zapier, Bun, Hono. Это документация, которую читают агенты разработчика. Человек кидает адрес файла в редактор кода, агент забирает справку целиком и дальше отвечает на вопросы по API, не бегая за каждой страницей.
Пределы такого подхода первыми нащупали те же документационные проекты. Svelte держит три размера сразу: сжатый на 13,6 тысячи токенов, сокращённый на 209 тысяч и полный на 293 тысячи, и прямо предлагает выбрать по объёму доступного контекста. Когда полный слепок перестаёт влезать в окно, приходится делать усечённые версии — то есть возвращаться к идее оглавления.
Для корпоративного сайта такого сценария просто нет. Никто не подключает справочник агентства к редактору кода, а разговор в чате устроен иначе: модель ищет ответ на конкретный вопрос и берёт одну страницу, а не весь сайт, — поэтому на попадание в ответы ChatGPT работает содержание самих страниц, а не второй файл.
Четыре сайта из выборки держат оглавление и сознательно обходятся без слепка: docs.github.com, docs.stripe.com, bitrix24.ru и сам llmstxt.org. Ещё девять доменов, включая vc.ru, habr.com, amocrm.ru и developers.sber.ru, не отдают ни одного из файлов.
Отдельная находка касается качества внедрения. Два файла из девятнадцати оказались побайтовой копией оглавления: у docs.expo.dev и elevenlabs.io/docs llms-full.txt и llms.txt совпали по контрольной сумме до последнего байта. Полного текста там нет, есть второй адрес с тем же содержимым. Кто-то включил галочку, файл появился, глазами его не открыли.
Разнобой заметен и в тех файлах, где текст настоящий. Cloudflare начинает слепок с YAML-фронтматтера страницы, Svelte и Hono открывают его тегом <SYSTEM>, Vercel разделяет страницы линейкой из дефисов, а ai-sdk.dev — комментарием со ссылкой на гайд для контрибьюторов. Единого формата нет, потому что нет и спецификации.
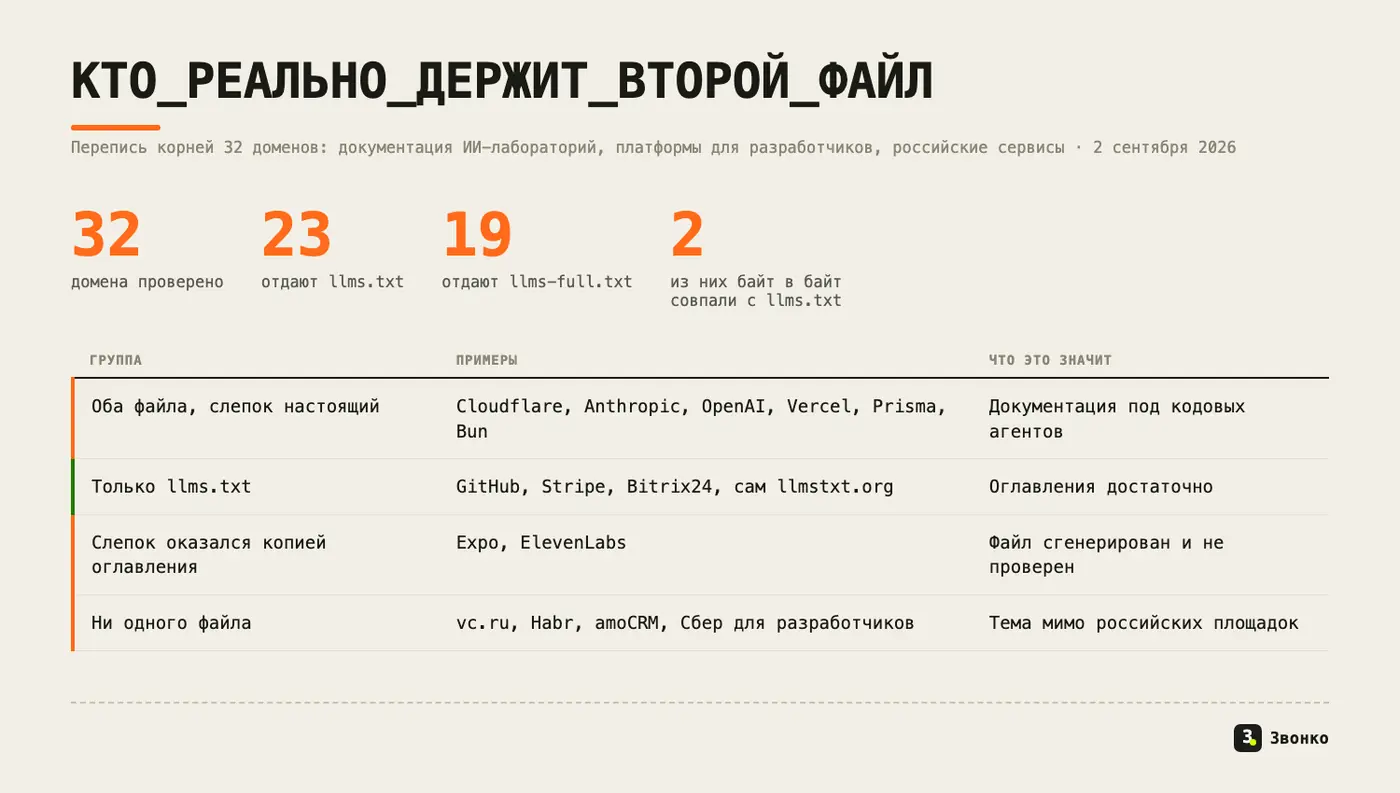 Проверка 2 сентября 2026, 32 домена.
Наш собственный сайт слепок отдаёт: 22 КБ и 4 471 токен, вдвое больше оглавления. Держим мы его по одной причине — сайт небольшой, файл собирается вместе со сборкой и не требует ухода. Рост упоминаний бренда в ответах нейросетей он не приносит: по замеру Limy.ai, на 515 млн событий бот-трафика пришлось 408 обращений к llms.txt, а Google в лице Джона Мюллера заявил, что ни одна ИИ-система файл не использует.
Отсюда порог, которым мы пользуемся в работе над видимостью сайта в нейросетях. Если весь текст сайта укладывается в 50–100 тысяч токенов и файл собирается автоматически при деплое, слепок можно завести как дешёвую страховку. Если объём больше, второй файл превращается в мегабайты, которые никто не прочитает целиком, а поддерживать его придётся руками.
Порядок сборки короткий, и каждый шаг здесь закрывает конкретную ошибку из тех, что мы видели в чужих корнях.
text/plain. Мануал curl описывает нужные флаги.curl -I https://example.ru/llms-full.txt # ждём 200 и text/plain
curl -s https://example.ru/llms.txt | md5
curl -s https://example.ru/llms-full.txt | md5 # суммы должны различаться
Если сайт при этом отдаёт Markdown-версии страниц по адресу с расширением .md и объявляет их заголовком Link, второй файл теряет последний смысл: агент забирает ровно ту страницу, которая нужна. Собрать и проверить само оглавление можно нашим бесплатным генератором и валидатором llms.txt, а как положить файл в корень на популярных платформах, разобрано в статье про llms.txt для Тильды и Битрикса.
Файлы стоят, а нейросети называют конкурентов?
Замерить видимость с Звонко →llms-full.txt — не вторая половина стандарта, а прикладной формат документационных платформ: спецификация о нём молчит, а вторая версия предложения ещё и убрала инструмент сборки контекста. Медианный слепок весит 716 тысяч токенов и целиком не читается, поэтому смысл он имеет там, где справку скачивают кодовые агенты. Сайту услуг достаточно аккуратного llms.txt, а место, откуда действительно берутся упоминания бренда, разобрано в материалах про техническую доступность сайта для ИИ и архитектуру сайта под ИИ-поиск.
llms.txt — короткое оглавление сайта со ссылками и описаниями, его задача уместиться в контекст модели целиком. llms-full.txt — весь текст сайта, слитый в один файл. Первый показывает дорогу, второй везёт весь груз сразу.
Нет. В тексте спецификации версии 2 от 10 августа 2026 года имя llms-full.txt не встречается ни разу. Это практика документационных платформ, а не часть стандарта.
По нашему замеру 32 доменов от 2 сентября 2026 года медиана составила 716 тысяч токенов. Самый тяжёлый файл — у документации Cloudflare: 54 МБ и 12,5 млн токенов, это в двенадцать раз больше самого большого контекстного окна.
Как правило нет. Файл окупается там, где документацию читают агенты разработчика и им удобно забрать её одним запросом. Сайту услуг на тридцать страниц второй файл не добавляет ничего сверх llms.txt.
Сравнить контрольные суммы: curl -s домен/llms.txt | md5 и то же для llms-full.txt. Два из девятнадцати найденных нами файлов оказались побайтовой копией оглавления.
Прямых подтверждений нет. По данным Limy.ai, на 515 млн событий бот-трафика ИИ пришлось 408 обращений к llms.txt, а Google устами Джона Мюллера заявил, что ни одна ИИ-система файл не использует. Видимость в ответах определяют позиции в поиске и содержание самих страниц.
 GEO
llms.txt советуют GigaChat и ChatGPT, а Алиса AI, Google и Claude — нет. Что это за файл, пример, нужен ли он сайту и почему Google его не использует.
Читать статью → GEO
Как разместить llms.txt на сайте под Tilda и 1С-Битрикс, что писать внутри по спецификации и как за одну команду проверить, что файл отдаётся, а не страница ошибки.
Читать статью → GEO
Нейросеть берёт источники в два этапа: сначала поиск собирает кандидатов, потом модель отбирает фрагменты. Что подтверждено документацией и данными, что миф.
Читать статью →Начнём с бесплатного экспресс-замера: покажем, как нейросети видят ваш бренд сейчас и где есть смысл работать.