ИИ-агенты для бизнеса: как посчитать окупаемость заранее
ИИ-агенты для бизнеса: чем агент отличается от чат-бота, какие задачи ему отдать, как посчитать окупаемость по тарифам Yandex AI Studio и GigaChat и что выбрать.
Читать статью →Написать текст нейросетью без одних и тех же правок: запрет в промпте кавычки не убирает, их ловит проверка — в журнале Звонко 9 из 11 повторов. Как сделать так же без программиста.
Коротко: запрет в инструкции не убирает кавычки на обычных словах: в журнале правок Звонко они уходили в публикацию, пока их не стала ловить проверка. Так устроены почти все частые правки, 9 из 11 повторов у нас ловит автоматика. Без программиста помогает список правил и проверка текста нейросетью по нему.
Черновик нейросеть выдаёт за минуту, а вычитка тянется дольше, и в следующем тексте всплывают те же кавычки, вводки и подытоги. Мы в Звонко с середины июля 2026 года записываем правки владельца в журнал. На 1 октября 2026 года в журнале правок Звонко 18 датированных записей и реестр из 11 повторяющихся дефектов, 9 из них уже ловит автоматическая проверка. Этот опыт переносится на ручную работу в ChatGPT, Алисе AI или GigaChat без программиста: записывать каждую правку, превращать её в правило и просить модель проверять текст по этим правилам с цитатами. Мы называем такой цикл петлёй правок.
Правка в одном тексте ничего не меняет в следующем: модель каждый раз начинает с чистого листа и повторяет свои привычки. Промпт меняет тему и формат, привычки остаются. Если попросить искусственный интеллект написать текст одной строкой, он выдаст среднее по своим привычкам: пустые вводки, кавычки на обычных словах, анонс вместо сути.
Повторяющиеся слова выдают машинный текст даже в научных статьях. Kobak и соавторы в Science Advances нашли избыточные слова-маркеры вроде delves, underscores и showcases и по ним оценили, что не менее 13,5% аннотаций PubMed 2024 года прошли через языковые модели. Редактор русских текстов видит то же самое, только маркеры другие.
Поисковики к самому факту генерации претензий не предъявляют. Google Search Central в руководстве от февраля 2023 года пишет, что использование ИИ само по себе правил поиска не нарушает, оцениваются качество и польза. Значит, работа редактора сводится к тому, чтобы убрать дефекты до публикации. Пока правила живут только в голове редактора, вычитывать каждый текст заново приходится человеку.
В журнале правок Звонко чаще всего повторяются кавычки на обычных словах, пустые вводки, подытоги, анонсы вместо сути и неудачные слова. Для каждого дефекта в журнале есть пример, а у большинства ещё и дата, с которой его ловит жёсткая проверка, то есть текст с таким дефектом дальше не проходит:
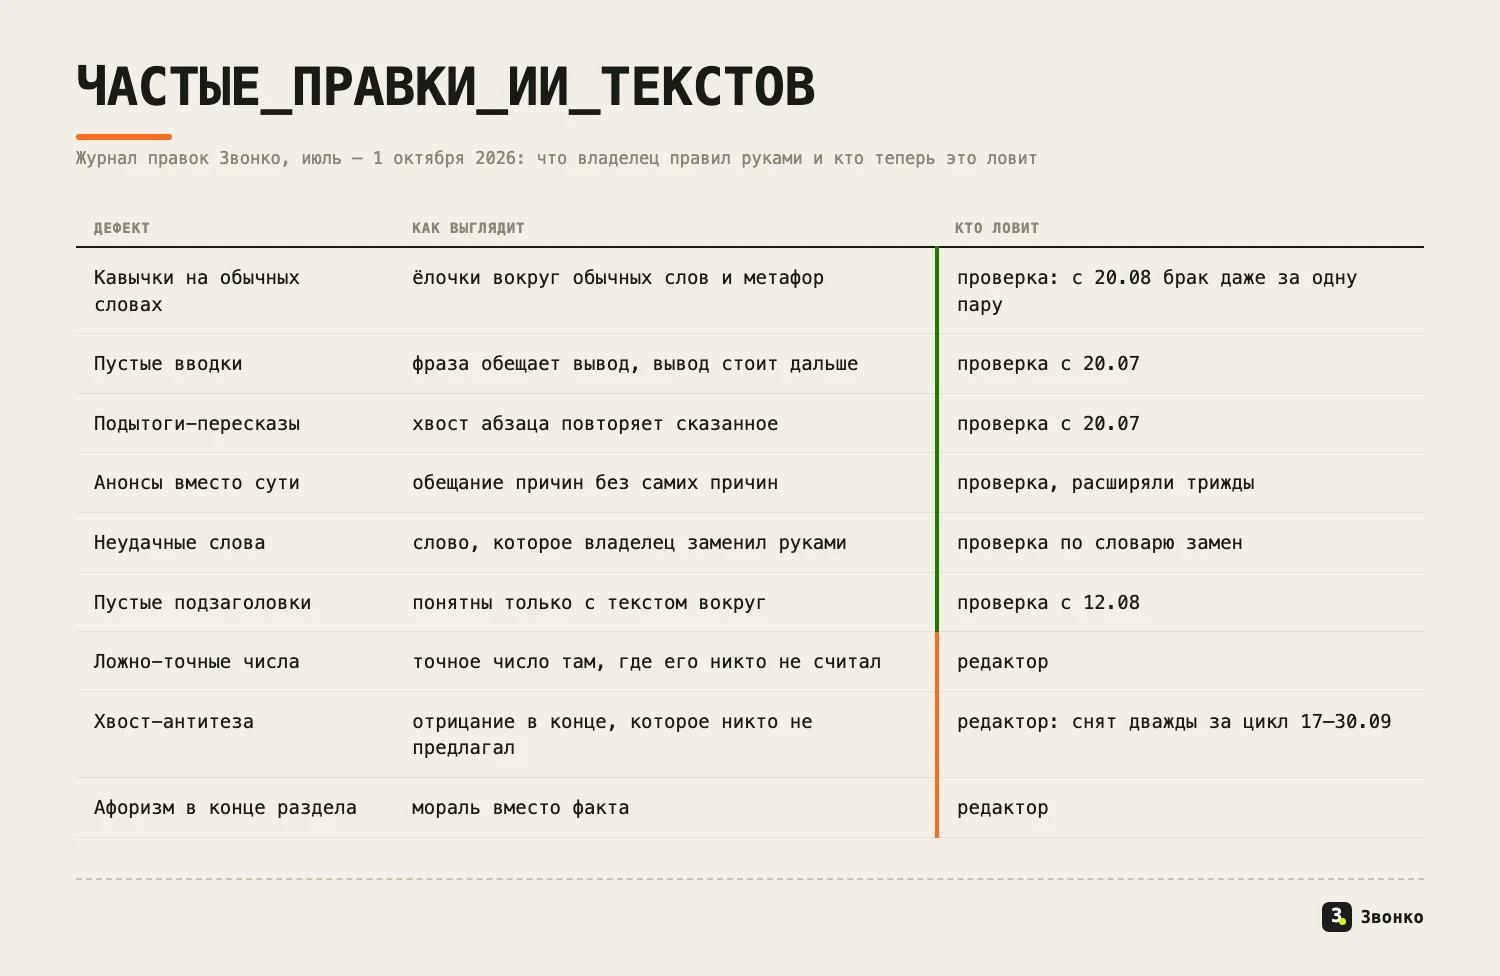 Шесть самых частых дефектов из журнала правок Звонко ловит проверка, ещё три держит редактор. Июль — 1 октября 2026.
Владельцу бизнеса, который пишет сам, достаточно общей таблицы в заметках: дата, фрагмент до правки, фрагмент после и название дефекта. Дефекты, которые в ней повторяются, становятся первыми правилами. Пары до и после из этой таблицы годятся и как готовые примеры для брифа.
Правило в брифе срабатывает, только если его заметили модель и редактор, а проверка срабатывает на каждом тексте. В журнале правок Звонко это видно на двух записях.
Первая — от 10.09.2026. В текстах для внешних площадок автор пишет о себе в единственном числе. Это правило было записано текстом с 20.07.2026, но владелец снова переписал руками фразу «Для проверки разобрали 358 ответов ИИ» на «Для проверки разобрал 358 ответов ИИ». Проверку перенесли в код, и первый же её прогон по архиву отправленных текстов нашёл ещё три нарушения, оставшихся незамеченными до сентябрьской правки владельца.
Вторая — от 01.10.2026. На хвост-антитезу правило есть только текстом, и за цикл 17–30.09 владелец снял такой хвост руками дважды. В код её сознательно не переводили: противопоставление с отрицанием — нормальная конструкция, и автомат резал бы правильный текст. Сколько часов правки экономит перенос в код, в журнале не записано, и обещать конкретное сокращение мы не будем.
Проверка в коде тоже промахивается, если решение принимает общий балл. В разборе от 16.07.2026 выяснилось, что детектор находил кавычки на обычных словах в 5 случаях из 5, но итог считался суммой по всем типам ошибок. Провал одного типа тонул в хорошем общем результате, и модель-редактор доверяла зелёному итогу, хотя запрет на такие кавычки уже стоял в её промпте. Кавычки уходили в публикацию. Теперь провал по одному типу ошибок бракует текст, даже если общий балл хороший.
Правка становится правилом за четыре действия: записать правку, найти класс дефекта, внести правило в бриф и добавить проверку, которая срабатывает до того, как текст увидит редактор. Класс важнее конкретной фразы: правят целый тип ошибки, например кавычки на обычных словах или анонс вместо сути. Правило в бриф пишут в форме что делать и с причиной, проверка превращает его в условие приёмки. В журнале правок Звонко правка владельца поднимается в правило с первого раза, ожидание второго повтора оставлено только для правок партнёров и площадок (запись от 13.08.2026).
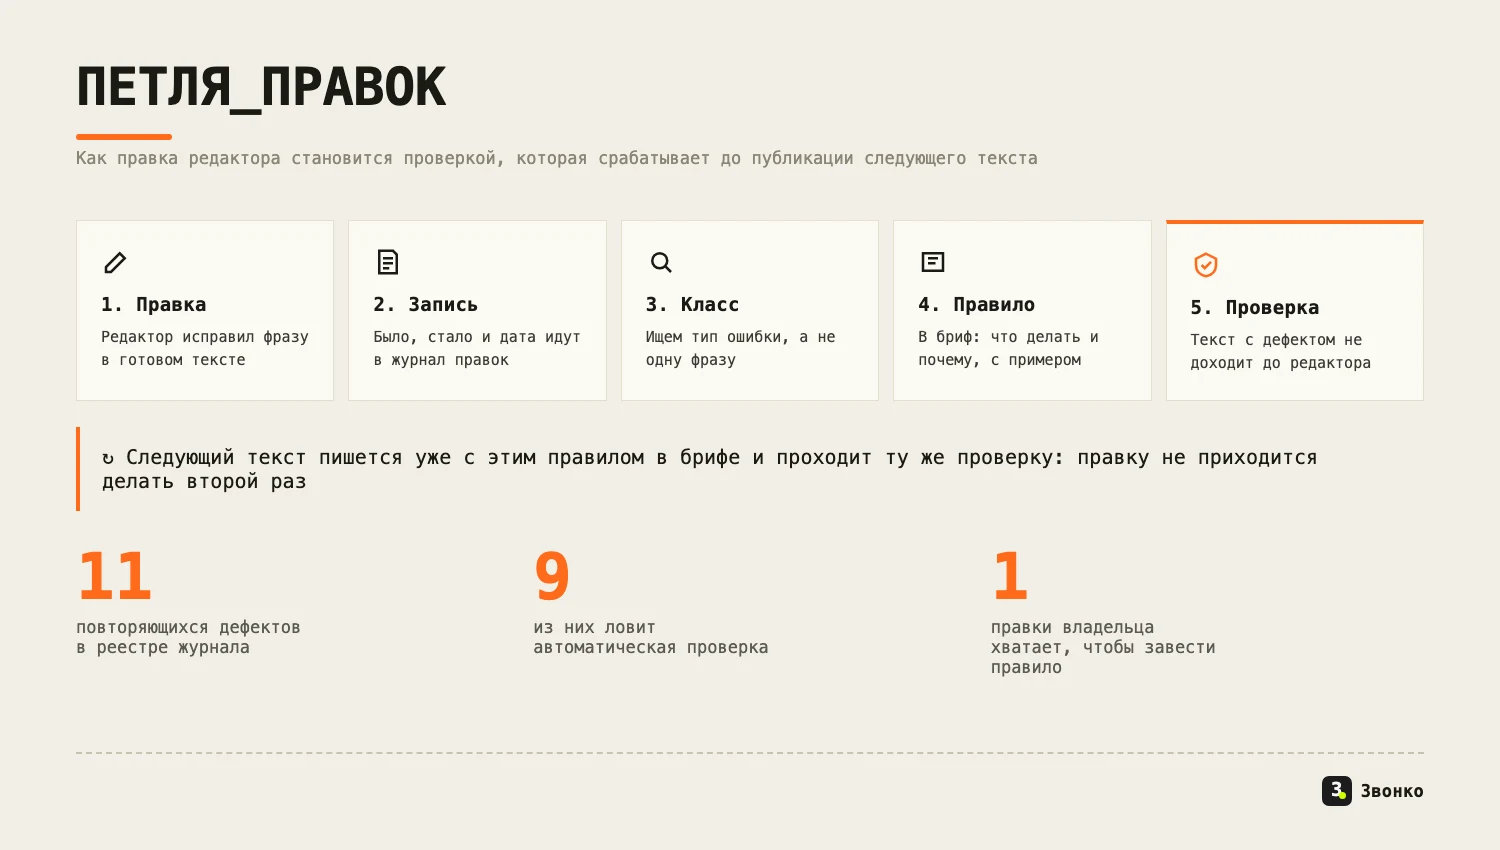 Петля правок: одна правка владельца становится правилом и проверкой для всех следующих текстов.
Сначала стоит убедиться, что правка настоящая. Когда сравнивают свой файл с опубликованной версией, большая часть расхождений оказывается мусором сравнения: подписи к картинкам, служебные шапки, подвал площадки. Правило, заведённое на такую разницу, борется с ошибкой, которой не было.
Новую проверку сначала прогоняют на двух-трёх своих свежих текстах: 12.08.2026 первая версия проверки подзаголовков забраковала наш правильный заголовок «Что запомнить», и правило сузили в тот же день. Как такие проверки встраивают в производство по шагам, описано в материале про автоматизацию производства контента.
Перед публикацией проверяют девять пунктов, собранных по журналу правок Звонко, и семь из них можно поручить модели. Любая нейросеть или чат-бот улучшит текст по такому списку, будь то ChatGPT, Алиса AI или GigaChat. Список кладут в запрос с формулировкой «Найди в тексте нарушения по списку, процитируй каждое и укажи номер пункта, ничего не исправляй».
Если по пункту нарушений нет, модель пишет это отдельной строкой, иначе пропуск не отличить от невнимательности. Цитата позволяет проверить каждую находку за секунды и отсечь выдуманное нарушение. Яндекс Cloud советует разбивать сложную задачу на серию коротких промптов, и здесь это уместно: первым запросом ищут нарушения, вторым просят исправить только отмеченные места.
Если текст пишется ради ответов нейросетей, к списку добавляют требования из статьи о том, как попасть в ответы ChatGPT. Под такую задачу у нас есть отдельная услуга продвижения в нейросетях.
При создании текста нейросетью помогают четыре приёма из руководств крупных разработчиков: роль, формат, объяснение причин и примеры. Руководство Anthropic советует объяснять модели, почему инструкция важна, и говорить, что делать, вместо того, чего не делать. Сбер в основах промпт-инжиниринга для GigaChat рекомендует задать роль в системном промпте и указать формат и стиль вывода.
Любая нейросеть для генерации текста отвечает точнее, когда видит образец. Anthropic называет 3–5 примеров, Яндекс Cloud в статье о промтах от 29 мая 2025 года — 1–2 образца идеального вывода, OpenAI в гайде по prompt engineering описывает несколько пар вход → выход. Лучшие примеры для брифа — пары до и после из своего журнала правок. Эти приёмы настраивают один запрос, а дефект, который вернётся в следующем тексте, ими не закрыть. Какие модели подходят под какие задачи, описано в статье про нейросети для создания контента.
Детектор выдаёт вероятность, а редактору нужна фраза, которую надо исправить, и сама вероятность ненадёжна. Liang и соавторы в журнале Patterns в 2023 году показали, что семь популярных детекторов пометили как сгенерированные больше половины из 91 эссе TOEFL, которые написали люди не на родном английском (пересказ есть на ScienceDaily). 20 июля 2023 года OpenAI закрыл собственный классификатор ИИ-текста из-за низкой точности, об этом писал TechCrunch.
Проверка по своим правилам устроена иначе: правило сформулировано, нарушение показано цитатой, исправление понятно. Так построен детектор Звонко, свой скрипт без внешних сервисов. Процента он не ставит, он называет конкретную фразу и тип ошибки: кавычки, вводки, анонсы, лексика. Повторяющаяся лексика выдаёт машинный текст, на этом признаке построена оценка Kobak и соавторов. Словарь замен в журнале правок Звонко работает с тем же признаком и пополняется при каждой правке слова.
Конвейер нужен, когда текстов десятки в месяц и чек-лист руками уже не справляется. Чтобы написать статью с ИИ на потоке, мы в Звонко пропускаем каждую через одну цепочку: модель-писатель делает три версии под разными углами, судья на более сильной модели выбирает лучшую, дальше работают редактор, проверка фактов и читатели. Пороги качества, которые держат на таком потоке, описаны в материале про SEO-тексты в масштабе.
Читатели — три роли из целевой аудитории: владелец бизнеса, маркетолог-заказчик и SEO-специалист. Они ставят оценки от 1 до 10 по четырём вопросам, и оценка ниже 7 возвращает статью редактору. Четвёртый читатель видит только заголовок и первый абзац и пересказывает мысль одной фразой.
Устройство такого производства описано в статье что такое контент-завод, цену настройки и абонемента считает отдельный разбор. Петлю правок под ваши тексты собирает контент-автоматизация Звонко: правки редактора там записываются как правила и проверяются до публикации.
Правите одно и то же в каждом тексте после нейросети? Настроим производство, где повторяющиеся правки становятся правилами и проверками до публикации. Первые 10 текстов — бесплатно.
Обсудить контент-автоматизацию →Совсем без правок не получится, и обещать это нельзя. В журнале правок Звонко правки появляются в каждом цикле. Меняется другое: дефект, на который есть проверка в коде, текст дальше не проходит, и редактору не нужно ловить его глазами. Правило, записанное только текстом, так не держит: хвост-антитезу, на которую есть лишь текстовое правило, владелец за цикл 17–30.09.2026 снял руками дважды.
Сравнения моделей у нас нет, поэтому называть победителя мы не будем. В журнале правок Звонко повторяются одни и те же дефекты: кавычки на обычных словах, пустые вводки, анонсы, подытоги. Снимают их примеры, роль, формат и список правил в брифе. Тот же набор приёмов советуют Anthropic, OpenAI, Яндекс и Сбер в своих руководствах по промптам. Какие модели встроить в производство и как, описано в статье про нейросети для создания контента.
Дайте модели список правил с одним примером исправления на каждое и попросите только найти нарушения. Рабочая формулировка: «Найди в тексте нарушения по списку, процитируй каждое и укажи номер пункта, ничего не исправляй». Цитата позволяет проверить находку за секунды и отсечь выдуманное нарушение. Если по правилу ничего нет, пусть модель пишет об этом отдельной строкой. Вторым запросом просят исправить только отмеченные места: Яндекс Cloud советует разбивать сложную задачу на серию коротких промптов.
Процент вероятности ИИ редактору мало что даёт. В исследовании Liang и соавторов семь популярных детекторов пометили как сгенерированные больше половины из 91 эссе TOEFL, написанных людьми не на родном английском, а OpenAI в июле 2023 года закрыл свой классификатор из-за низкой точности. Полезнее проверка, которая показывает конкретную фразу и тип ошибки: кавычки, пустая вводка, анонс, лексика. Так устроен детектор Звонко: процент он не выставляет, по его отчёту сразу видно, что исправить.
По руководству Google Search Central от февраля 2023 года использование ИИ само по себе правил поиска не нарушает: оцениваются качество и польза текста, то есть E-E-A-T. Данных о том, как Яндекс относится к текстам, написанным нейросетью, у нас нет, и утверждать что-либо мы не будем. Безопасный порядок одинаков для обоих поисков: проверять факты, давать читателю пользу и не публиковать текст, который никто не вычитал.
Руководства называют разные числа. Anthropic советует 3–5 примеров в тегах example, Яндекс Cloud — 1–2 образца идеального вывода, OpenAI описывает несколько пар вход → выход с разнообразными входами. На практике начинают с одного-двух образцов и добавляют новые, когда в журнале правок появляется дефект, который образцы не закрывают. Примеры стоит делать разными по теме и длине, чтобы модель не копировала один из них слишком буквально.
Генерация текста — это сам ответ модели на запрос. ИИ-копирайтинг шире: бриф, образцы, правила, проверка и редактура вокруг этого ответа, как в обычной редакции. Модель в таком процессе пишет первый черновик, а за качество отвечает цепочка проверок. Если процесс сводится к одному запросу и публикации, получается сырая генерация, и все правки достаются редактору или читателю.
 ИИ-агенты
 для бизнеса: чем агент отличается от чат-бота, какие задачи ему отдать, как посчитать окупаемость по тарифам Yandex AI Studio и GigaChat и что выбрать.
Читать статью → Контент-завод
Как создать контент завод на n8n и нейросетях: девять шагов с узлами, тарифы и цены API, места поломок и то, что сценарий не сделает сам: проверку фактов, пороги и редактора.
Читать статью → SEO
Какие SEO-задачи отдать нейросети: группировку запросов, разбор выгрузки краулера, черновики и разметку. Где модель подменяет частоты и аудит и когда Google считает ИИ-тексты спамом.
Читать статью →Начнём с бесплатного экспресс-замера: покажем, как нейросети видят ваш бренд сейчас и где есть смысл работать.