Как ИИ выбирает источники: что доказано, а что миф
Нейросеть берёт источники в два этапа: сначала поиск собирает кандидатов, потом модель отбирает фрагменты. Что подтверждено документацией и данными, что миф.
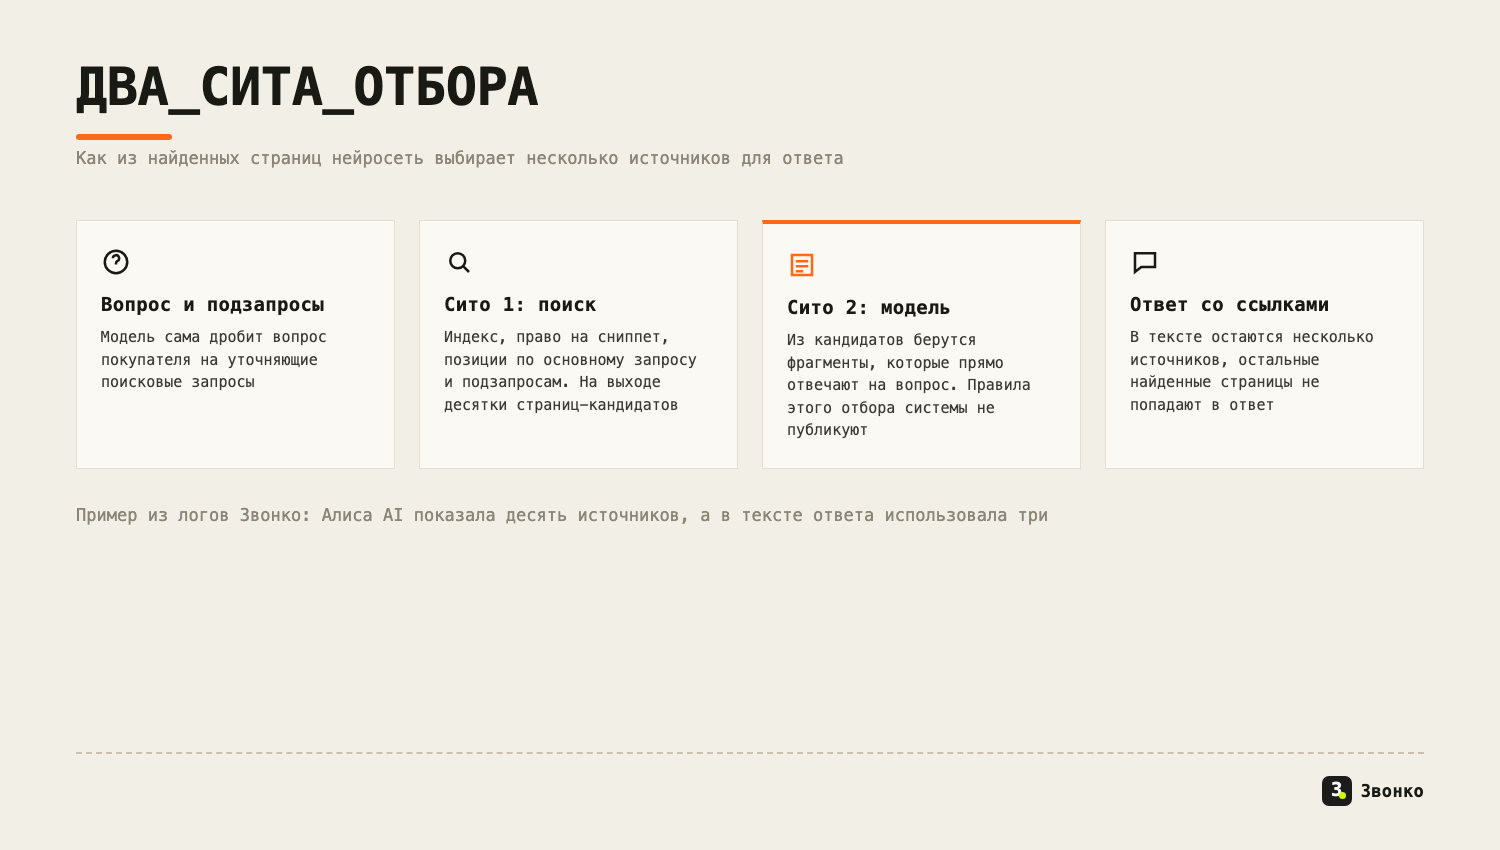
Коротко: нейросеть выбирает источники в два этапа: поиск собирает подходящие страницы по вопросу и его подзапросам, затем модель берёт из них абзацы с прямым ответом. Это важно, потому что рынок повторяет недоказанные приёмы, например llms.txt. Опору в данных имеют индексация, позиции по подзапросам и законченные абзацы.
Допустим, покупатель спрашивает у Алисы AI или ChatGPT, к кому обратиться в вашей категории, и получает ответ с несколькими ссылками. За ними стоит десяток найденных страниц, которые нейросеть видела и не взяла. Мы в Звонко сверили документацию Google, Яндекса, OpenAI и Perplexity с исследованиями и своими логами: правила второго отбора не раскрывает ни одна система, и всё, что о нём пишут, держится на экспериментах, корреляциях или пересказах. Если принять пересказ за правило, бюджет уходит на приёмы, которые не влияют на цитирование, например на файл llms.txt. Весь путь запроса от вопроса до ответа описан в статье про генеративный поиск.
Как нейросети находят сайты, из которых потом выбирают источники
Позиции по подзапросам связаны с цитированием заметно. Surfer SEO взял 10 000 ключевых слов и проверил, какие страницы цитирует AI Overviews, обзор от ИИ над выдачей Google. Страницы, которые стоят в выдаче и по основному запросу, и хотя бы по одному дополнительному запросу, цитируются в 2,6 раза чаще, чем страницы с позицией только по основному. Это корреляция, и авторы сами оговаривают, что дополнительные запросы подстраиваются под пользователя и при повторе совпадают лишь примерно в 27% случаев.
Тот же отчёт показывает обратную сторону: 67,82% всех цитат AI Overviews не нашлись в топ-10 ни по основному запросу, ни по подзапросам. Топ-10 полезен, но кандидаты им не исчерпываются. Google и сам пишет, что подбирает для обзора более разнообразный набор ссылок, чем классический поиск.
Как нейросети выбирают источники из найденных страниц
Второе сито отбирает фрагменты, которые прямо отвечают на вопрос, и его правила не раскрывает ни одна система. Google пишет только, что ссылки в ответе подтверждают информацию из ответа. Яндекс говорит, что генерирующая модель собирает найденное в один материал и приводит ссылки. Как именно из кандидатов выбирается ссылка, не публикуют ни Google, ни Яндекс, ни OpenAI, поэтому всё, что известно о втором сите, — исследования и наблюдения.
Пример из логов Звонко: на вопрос «GEO или SEO» Алиса AI показала десять источников, а в тексте ответа использовала три, и все три были сравнениями. По тому же вопросу нейросети нашли около трёх десятков страниц. Повторялись между системами меньше десятка из них, и большинство повторов — сравнения с вопросом в заголовке. Страниц услуг было единицы, и каждую взяла только одна нейросеть. Это снимок одного вопроса за один день, правилом его считать нельзя. Направление при этом видно: чаще берут страницу, которая отвечает на вопрос покупателя.
Совпадение слов иногда перевешивает смысл. В тех же логах Звонко статья про локальное геозависимое продвижение попала в источники трёх нейросетей на вопрос про GEO-оптимизацию: её заголовок совпал с вопросом по словам. Покупателя, которому нужна услуга, такая ссылка не приводит, так что повторять этот приём незачем. Как связаны поиск и генерация ответа, мы разобрали в статье что такое RAG.
Какие признаки цитирования в нейросетях подтверждены, а какие нет
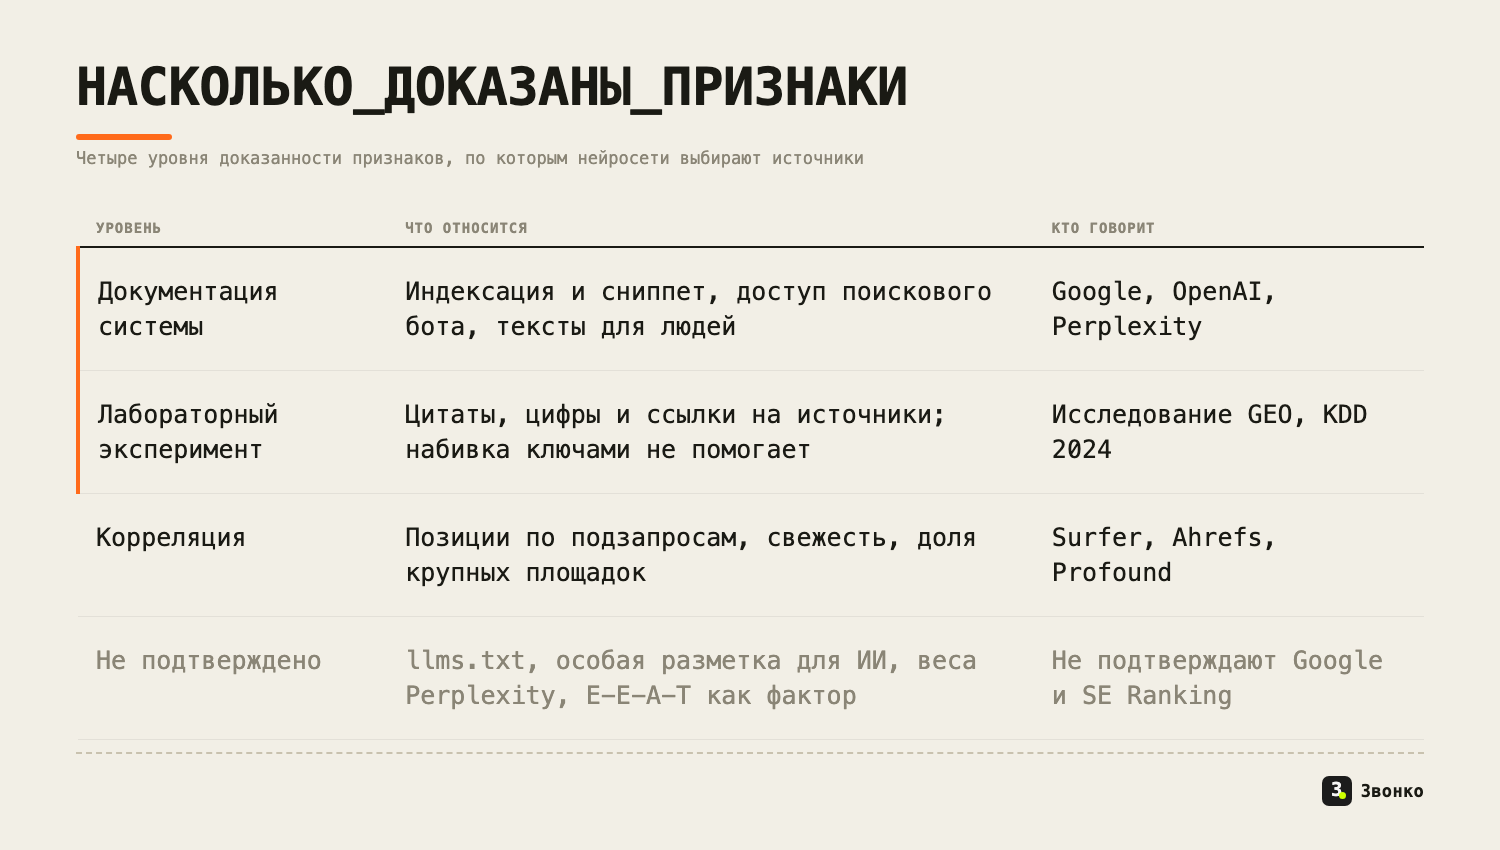
Признаки отбора стоят на четырёх уровнях доказанности, и смешивать их нельзя. Одни заявлены самими системами, другие получены в лабораторных экспериментах, третьи видны только по корреляциям. Четвёртые рынок повторяет без первоисточника.
Уровень
Что относится
Источник
Документация системы
индексация и право на сниппет; доступ бота в robots.txt; тексты для людей, без особой нарезки
Google, OpenAI, Perplexity
Лабораторный эксперимент
цитаты, цифры и ссылки на источники поднимают долю страницы в ответе; набивка ключами не помогает
исследование GEO
Корреляция
позиции по подзапросам; свежесть; доля крупных площадок
Surfer, Ahrefs, Profound
Не подтверждено
llms.txt, особая разметка для ИИ, веса Perplexity, E-E-A-T как отдельный фактор
Google, SE Ranking
Эксперимент провели авторы работы, которая дала название GEO (оптимизация под генеративный поиск), её представили на конференции KDD 2024. На наборе из 10 000 запросов они переписывали страницы и смотрели, какая доля их слов попадёт в ответ. Лучше других работали добавление цитат, статистики и ссылок на источники, а набивка ключевыми словами выигрыша не давала. Эффект зависел от позиции страницы в выдаче лабораторного движка из эксперимента, а не в Google или Яндексе. Для страниц на первом месте ссылки на источники снижали видимость на 30,3%. Для страниц на пятом месте та же правка поднимала её на 115,1%. Упрощённое «+40%» из пересказов — максимум на лабораторном движке, для живой выдачи этот результат не проверен.
Чем различаются источники у Google, Алисы AI, ChatGPT и Perplexity
Универсального списка источников нет: у каждой нейросети свой набор, и пересекаются они слабо. В прогоне Звонко летом 2026 года нейросети сослались примерно на три сотни доменов, и почти три четверти из них встретились только в одной системе. Любые две нейросети делили между собой от десятой до пятой части доменов. Ядро, видное почти везде, маленькое: vc.ru, Sostav, DTF и Habr были у всех систем прогона.
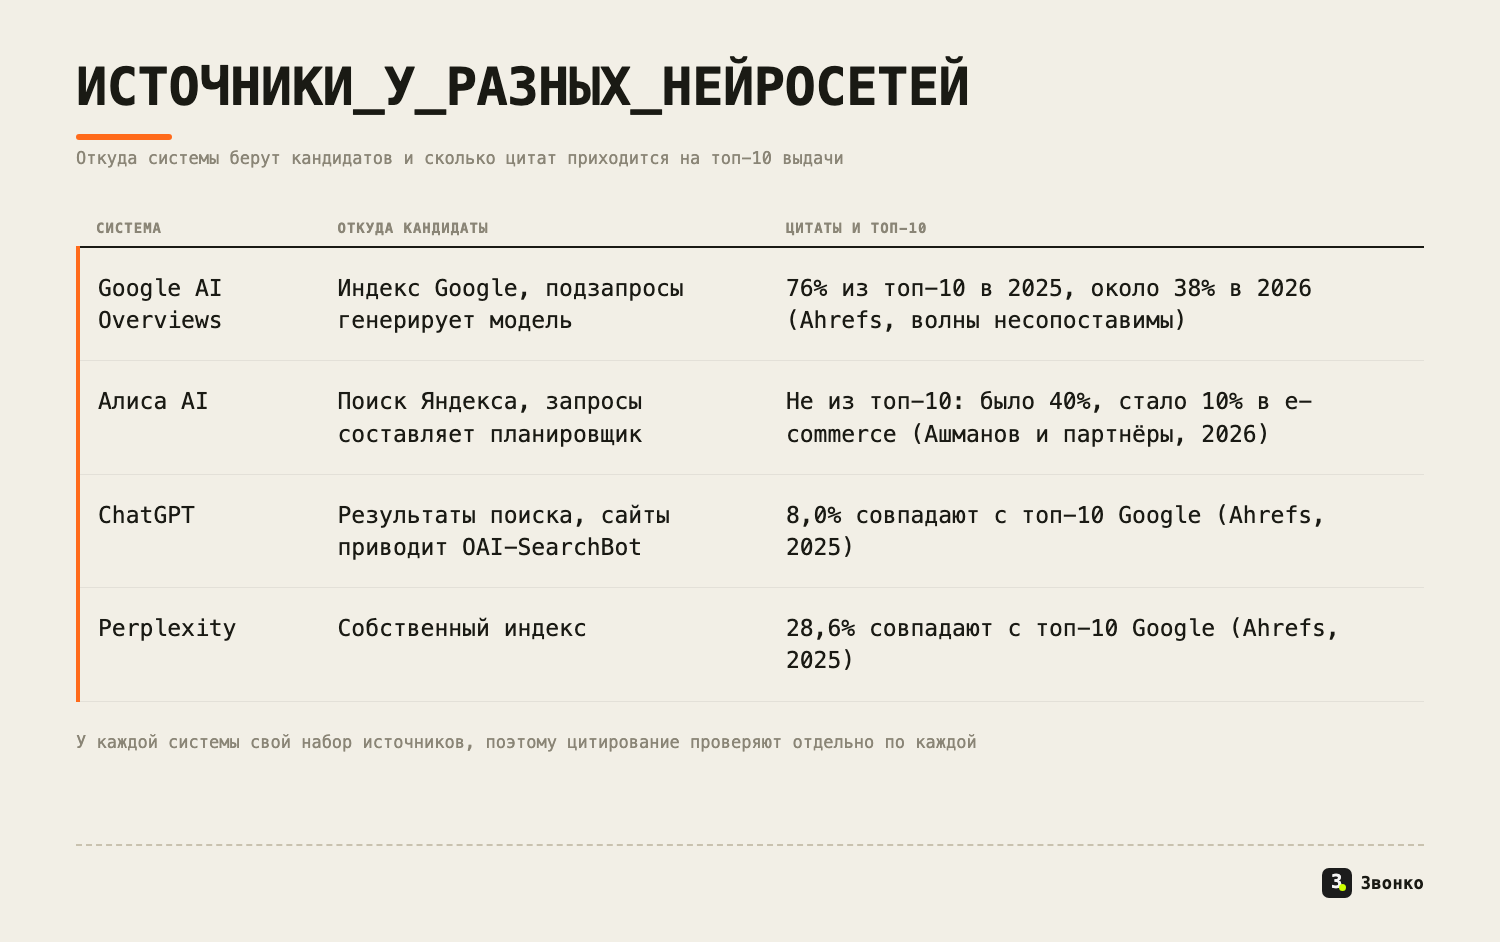
Google AI Overviews и AI Mode. Кандидаты берутся из индекса Google. Доля цитат из топ-10 по Ahrefs упала с 76% в июле 2025 года до 38% в начале 2026-го. Ahrefs сам указывает, что сбор данных улучшился и две волны напрямую несопоставимы. В прогонах Звонко по русским вопросам около половины источников AI Overviews были с доменов первой страницы обычной выдачи.
Алиса AI. Планировщик Яндекса — модель, которая сама составляет поисковые запросы, — работает поверх поиска Яндекса. Ашманов и партнёры в июне 2026 года зафиксировали падение доли сайтов не из топ-10 с 40% до 10% за полгода, выборка — запросы из e-commerce. В одном прогоне Звонко около половины ссылок Алисы AI были вне топ-10 органики. Оба факта — снимки по разным вопросам, и вместе они говорят, что привязка к топу есть, но не абсолютная. Практику описывает статья как попасть в ответы Алисы и страница продвижения в Алисе AI.
ChatGPT и Perplexity. Ahrefs прогнал 15 000 длинных запросов и сравнил цитаты с топ-10 Google по тому же запросу. В топ-10 Google нашлись 28,6% цитат Perplexity, у ChatGPT — 8,0%. Perplexity при этом ищет по собственному индексу. Для ChatGPT практику разбирает статья как попасть в ответы ChatGPT и страница продвижения в ChatGPT.
Что сделать сайту, чтобы нейросеть выбрала его источником
Начинать стоит с условий, которые системы называют прямо, и только потом переходить к приёмам из исследований.
Проверьте индекс и сниппет. Страницы в индексе, без noindex и nosnippet. Других технических условий Google не называет.
Откройте поисковых ботов. OAI-SearchBot и PerplexityBot не должны быть закрыты в robots.txt, иначе ChatGPT и Perplexity не покажут сайт в ответах поиска.
Закройте подвопросы покупателя. Если он сравнивает варианты и спрашивает про цену и сроки, под каждую отдельную тему нужен отдельный законченный раздел с вопросом в подзаголовке. Подвопросы прикиньте по подсказкам поиска и вопросам, которые покупатели задают вам. Позиции по подзапросам связаны с цитированием, а в логах Звонко чаще брали сравнения, чем страницы услуг.
Начинайте раздел с прямого ответа. Дальше — числа с названием источника и ссылки на первоисточники. Это приёмы из лабораторного эксперимента GEO. Для страниц на первом месте там ссылки на источники даже снижали видимость, так что рост для сайта не гарантирован.
Обновляйте содержимое, а не дату. Свежесть связана с цитированием, но одна новая дата без правок страницу не меняет.
Если покупатели в вашей нише читают vc.ru, Habr или Sostav, присутствие там добавляет шансов: эти площадки нейросети в прогоне Звонко брали чаще других. Общий порядок работ описывает статья про GEO-оптимизацию под ответы ИИ, а продвижение в нейросетях мы в Звонко ведём от замера видимости до правок страниц.
Как проверить цитирование своего сайта в каждой нейросети
Проверка делается по вопросам и отдельно по каждой нейросети, потому что наборы источников у них разные. Составьте перечень вопросов покупателей, задайте каждый каждой системе несколько раз и записывайте, какие домены названы в тексте и какие ссылки стоят в ответе. Один ответ даёт цитату, а не измерение: подзапросы меняются от повтора к повтору, ответы подстраиваются под пользователя.
Сначала убедитесь, что система искала в интернете, а не отвечала по памяти. Потом считайте долю вопросов, где назван ваш домен, и сравнивайте её с конкурентами в той же системе. В Search Console трафик из ИИ-функций Google отдельно не выделен, поэтому клики для этой задачи не годятся. Пошаговую проверку мы описали в статье как проверить, называет ли вас нейросеть.
Главный вопрос пока открыт: по каким признакам модель выбирает фрагмент из найденного. Ни одна система этого не публикует, а работают ли лабораторные приёмы GEO в Алисе AI или ChatGPT так же, как в эксперименте, данных нет. Поэтому мы в Звонко опираемся на то, что можно проверить: индекс, позиции по подзапросам и повторяемый замер по каждой нейросети.
Частые вопросы
Как нейросети находят сайты, которые потом цитируют?+
Через поисковый индекс. Google пишет, что материалы для ответа берёт из релевантных свежих страниц своего индекса, а страница должна быть проиндексирована и иметь право на сниппет. Яндекс описывает для поиска с Алисой AI модель, которая сама составляет поисковые запросы. В ChatGPT сайты в поиск приводит бот OAI-SearchBot: если закрыть его в robots.txt, сайт в ответах поиска ChatGPT не покажется.
Как нейросети выбирают источники из найденных страниц?+
Правила этого отбора не публикуют ни Google, ни Яндекс, ни OpenAI. Известно, что ответ собирает генеративная модель из найденного, а ссылки подтверждают сказанное в ответе. В лабораторном эксперименте GEO лучше работали страницы с цитатами, цифрами и ссылками на источники. Это результат эксперимента, а не заявленное правило систем.
Нужен ли llms.txt, чтобы цитирование в нейросетях росло?+
Подтверждений нет. Google в гайде по ИИ-функциям от 10 июля 2026 года пишет, что такие файлы ему не помогают и не вредят. SE Ranking на выборке почти из 300 000 доменов (15 октября 2026 года) не нашёл связи между llms.txt и цитированием. Время лучше потратить на индексацию страниц и законченные ответы в тексте.
Достаточно ли быть в топ-10, чтобы нейросеть процитировала сайт?+
Нет, и доля зависит от системы. В Google AI Overviews, по данным Ahrefs, из топ-10 были 76% цитат в июле 2025 года и 38% в начале 2026-го, но методика сбора изменилась. У ChatGPT в тесте Ahrefs в топ-10 Google было около 8% цитат, у Perplexity 28,6%. У Алисы AI в запросах e-commerce доля сайтов не из топ-10 упала с 40% до 10%, по данным Ашманова и партнёров. Проверять нужно каждую систему отдельно.
Влияет ли свежесть страницы на то, что её цитирует нейросеть?+
Связь есть, причинность не доказана. По данным Ahrefs, ссылки в ответах ИИ-ассистентов в среднем на четверть свежее, чем в обычной выдаче Google: 1064 дня против 1432. Автор исследования оговаривает, что свежесть — один из многих факторов. Обновлять страницу стоит содержимым, одна новая дата ничего не даёт.
Как проверить цитирование своего сайта в нейросетях?+
Составьте набор вопросов покупателей, задайте их каждой нейросети по несколько раз и записывайте, какие домены названы и какие ссылки стоят в ответе. Один ответ даёт цитату, а не измерение: подзапросы меняются от повтора к повтору. В Search Console трафик из ИИ-функций Google отдельно не выделен, поэтому считать нужно по вопросам и отдельно по каждой системе.
ОБ АВТОРЕ
Сергей БурыйСооснователь Звонко. Эксперт по практическому применению ИИ, главный редактор международных медиапроектов, преподаватель СПбГУ