Как ИИ выбирает источники: что доказано, а что миф
Нейросеть берёт источники в два этапа: сначала поиск собирает кандидатов, потом модель отбирает фрагменты. Что подтверждено документацией и данными, что миф.
Читать статью →GPTBot собирает тексты для обучения OpenAI, а в ответы ChatGPT сайт приводит OAI-SearchBot. Какие роботы есть у Claude, Perplexity, Google и Яндекса и три готовых robots.txt.
Коротко: решайте по каждому роботу отдельно: GPTBot собирает тексты для обучения OpenAI, а в ответах ChatGPT сайт показывает OAI-SearchBot. Ответы Алисы AI берутся из обычного поиска Яндекса, убрать из них сайт можно группой для YandexAdditional. Мы в Звонко сверили это с документацией 13.10.2026.
Допустим, вы не хотите, чтобы нейросети учились на текстах вашего сайта, и собираетесь закрыть их одной строкой в robots.txt. Мы в Звонко прошли по документации OpenAI, Anthropic, Perplexity, Google и Яндекса и выписали, какой робот за что отвечает. Главная находка: у каждой нейросети два-три робота с разными задачами, и запрет, поставленный не тому, бьёт мимо цели. Закроете поисковый робот ChatGPT вместо робота обучения, и сайт пропадёт из ответов, где его могли бы посоветовать вашему клиенту.
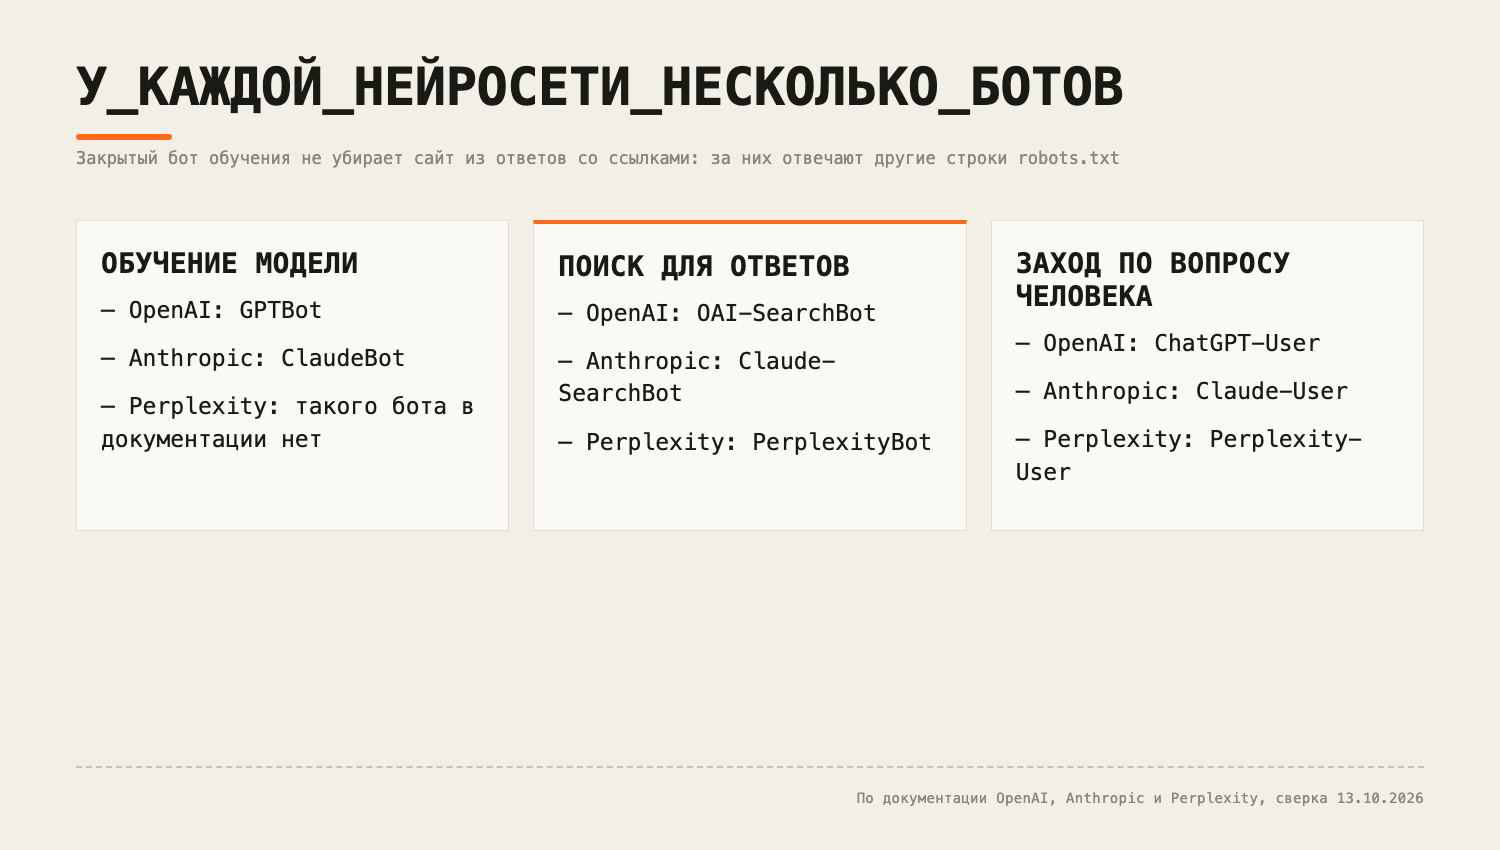
GPTBot — робот OpenAI, который обходит страницы для обучения генеративных моделей. Запрет Disallow: / для него означает, что материалы сайта не должны попадать в обучение базовых моделей. По документации OpenAI, у компании три робота с разными задачами, и настраиваются они независимо друг от друга.
OAI-SearchBot работает на поиск ChatGPT: находит сайты и показывает их в ответах. ChatGPT-User заходит на страницу, когда человек сам попросил об этом в чате или в пользовательском GPT. Про него в документации сказано, что запросы инициирует пользователь и правила robots.txt могут не применяться. Чтобы убрать сайт из поиска ChatGPT, OpenAI советует закрывать OAI-SearchBot, а не ChatGPT-User.
После правки robots.txt системам OpenAI нужно около 24 часов. Если открыты оба робота, OpenAI может использовать один обход для обеих задач, чтобы не ходить на сайт дважды. Диапазоны IP каждого робота компания публикует отдельным JSON-файлом, по нему настоящего GPTBot отличают от подделки.
Нет: GPTBot и OAI-SearchBot настраиваются отдельно, и можно запретить обучение, оставив показ сайта в поиске ChatGPT. Документация OpenAI прямо описывает такую комбинацию. Сайты, закрытые для OAI-SearchBot, наоборот, не показываются в ответах поиска ChatGPT, хотя могут остаться навигационной ссылкой.
Как сайты закрывают на практике, видно по исследованию Ahrefs от 21.05.2025: в нём разобрано около 140 млн сайтов. Любой запрет для GPTBot, включая общий запрет всем роботам, стоит у 5,89% сайтов. Явно, по имени GPTBot, его закрыли только 0,50%. У OAI-SearchBot любой запрет есть у 5,54% сайтов, а по имени его закрыли 0,08%. Выходит, большинство сайтов, закрытых для GPTBot, попали под общий запрет и решения по каждому роботу не принимали.
У новостных изданий картина другая. Reuters Institute 22.02.2024 разобрал архивные robots.txt конца 2023 года у 15 самых используемых новостных сайтов в каждой из десяти стран. Краулеры OpenAI блокировали 48% из них. Выборка только новостная, на другие ниши её не переносят.
Перед запретом стоит решить, что вы готовы потерять. Запрет GPTBot ссылок из ChatGPT не отнимает. Запрет OAI-SearchBot лишает сайт шанса попасть со ссылкой в ответы поиска ChatGPT. Что ещё нужно странице для таких ответов, мы разбирали в статье как попасть в ответы ChatGPT.
У OpenAI и Anthropic роботы делятся на три роли: обучение, поиск и заход по запросу пользователя. У Perplexity две роли, поиск и заход по запросу: бота для обучения в документации нет. У Google, Яндекса и Apple вместо отдельных роботов для ИИ есть управляющие токены: это имена для robots.txt, под которыми на сайт никто не ходит, но по ним компания решает, можно ли отдавать собранное обычным роботом в ИИ. Таблица собрана по документации самих компаний, сверка 13.10.2026; столбец «что будет» пересказывает их формулировки.
| Бот | Зачем ходит | Что будет, если закрыть |
|---|---|---|
| GPTBot (OpenAI) | Обход для обучения генеративных моделей | Материалы не должны использоваться для обучения |
| OAI-SearchBot (OpenAI) | Показ сайтов в поиске ChatGPT | Сайт не появится в ответах поиска ChatGPT, останется разве что навигационная ссылка |
| ChatGPT-User (OpenAI) | Заход по действию пользователя в ChatGPT и GPT | Правила robots.txt могут не применяться; на показ в поиске не влияет |
| ClaudeBot (Anthropic) | Сбор контента, который может пойти в обучение | Будущие материалы сайта исключаются из датасетов обучения |
| Claude-SearchBot (Anthropic) | Улучшение качества поиска Claude | Может снизить видимость и точность в результатах поиска Claude |
| Claude-User (Anthropic) | Заход по запросу пользователя Claude | Может снизить видимость при поиске, который запросил пользователь |
| PerplexityBot (Perplexity) | Показ и ссылки на сайты в поиске Perplexity; не для обучения | Сайт не будет показан в поиске Perplexity |
| Perplexity-User (Perplexity) | Заход по запросу пользователя | По документации в целом игнорирует robots.txt |
| Google-Extended (Google) | Управляющий токен: обучение Gemini и подстановка контента в Gemini Apps и Vertex AI | Касается только Gemini; на поиск Google, ранжирование и AI Overviews не влияет |
| YandexAdditionalBot (Яндекс) | Управляющий токен: показ в ответах Алисы AI и быстрых ответах | Контент уходит из ответов Алисы AI за 2–14 дней, сайт остаётся в поиске |
| Applebot-Extended (Apple) | Управляющий токен: обучение моделей Apple | Данные Applebot могут по-прежнему давать контекст в ответах Siri и Search |
| CCBot (Common Crawl) | Открытый архив веб-страниц | Страницы не собираются в архив; поддельные CCBot встречаются |
| Meta-ExternalAgent (Meta) | Обучение моделей и улучшение продуктов Meta | Материалы не идут в обучение |
| Meta-WebIndexer (Meta) | Индекс для поиска Meta AI | Meta AI теряет возможность цитировать сайт со ссылкой |
У Anthropic в статье от 07.04.2026 сказано, что его роботы соблюдают запреты из robots.txt, и оговорки про обход правил для Claude-User нет. У Perplexity такая оговорка есть: раз запрос исходит от пользователя, загрузчик Perplexity-User в целом игнорирует robots.txt. У Google Google-Extended не имеет своего HTTP user agent: на сайт заходят обычные роботы Google, а токен лишь управляет тем, как используется собранное.
Опубликованного user-agent для GigaChat, который можно вписать в robots.txt, у Сбера мы не нашли. Официальной документации по Bytespider (ByteDance) тоже нет, поэтому о его поведении по первоисточнику судить нельзя.
В Яндексе и Google ответы с ИИ строятся из обычного поискового индекса, поэтому запрет основного поискового робота бьёт и по выдаче, и по источникам ответов. У Яндекса есть оговорка: закрытая в robots.txt страница может остаться в поиске, убирает её noindex. Справка Яндекса пишет, что Алиса AI опирается на источники, которые высоко ранжируются в поиске. Отдельного робота под ответы Алисы AI нет: страницы берутся из индекса, который собирает основной поисковый робот Яндекса YandexBot.
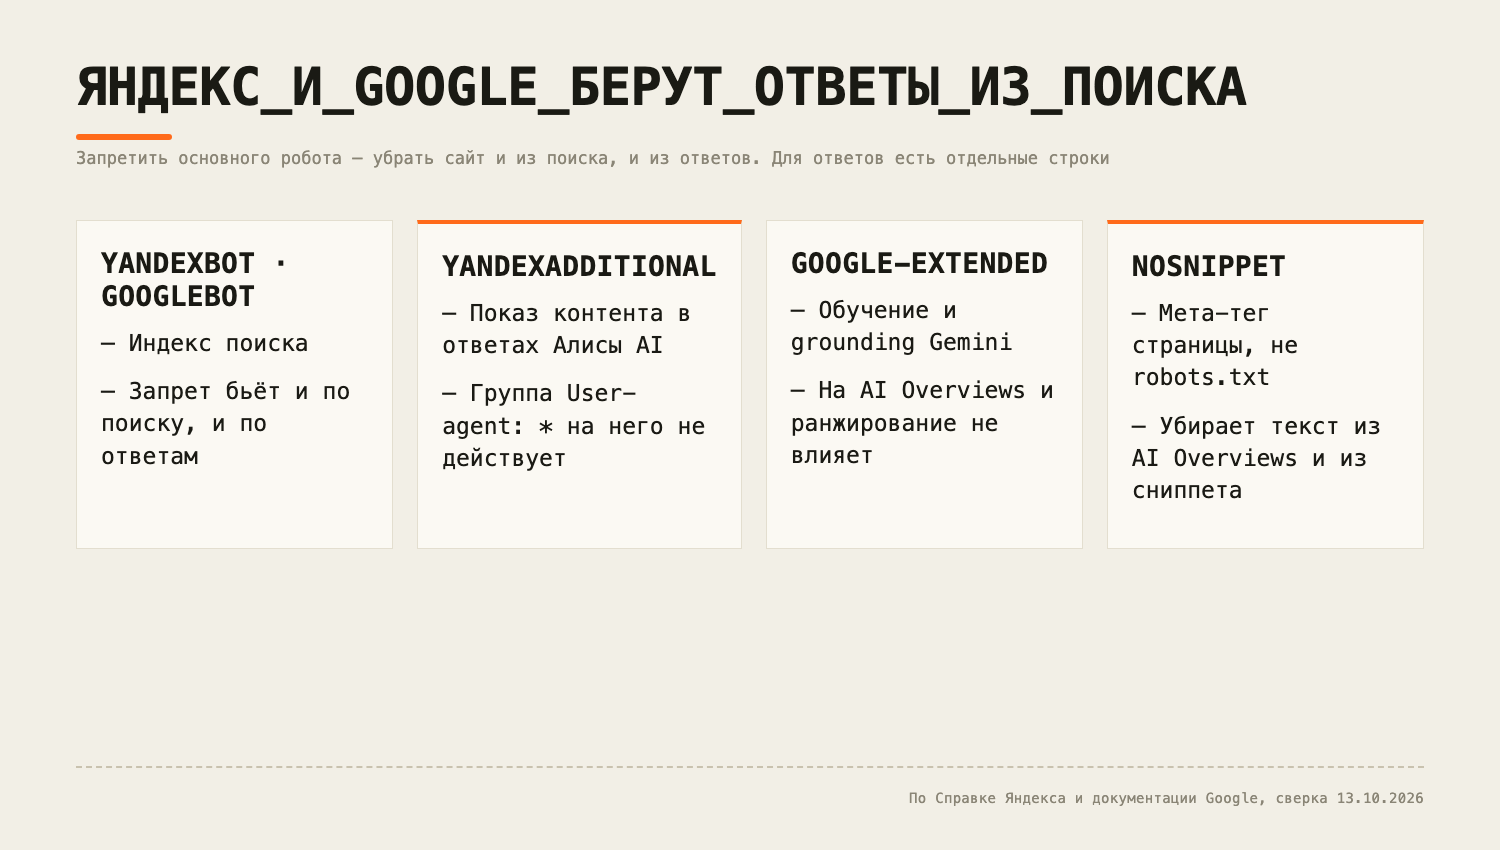
Отдельный управляющий токен при этом есть. Про роботов YandexAdditional и YandexAdditionalBot Справка пишет: они учитываются при обработке robots.txt, чтобы ограничить показ контента в быстрых ответах и в ответах Поиска с Алисой, и сами страницы не запрашивают. Правила из блока User-agent: * на них не действуют, нужен отдельный блок. Изменение учитывается за 2–14 дней, инструкция по запрету лежит в Справке. Токена YandexAI, который встречается в сторонних подборках, в Справке Яндекса нет, и вписывать его в файл бессмысленно.
У Google устройство похожее. По документации о функциях ИИ в Поиске (обновлена 10.12.2025), чтобы попасть в AI Overviews и AI Mode, странице достаточно быть проиндексированной и иметь право на показ со сниппетом, других технических требований нет. Управляют этим через Googlebot и директивы nosnippet, data-nosnippet, max-snippet и noindex. Директива nosnippet, по справке Google, не даёт использовать контент как прямой вход для AI Overviews и AI Mode, но убирает сниппет и из обычной выдачи. Google-Extended к AI Overviews отношения не имеет. Как устроен режим ответов Google, мы описали в статье про Google AI Mode, про Яндекс — в разборе, как попасть в ответы Алисы.
Файл robots.txt лежит в корне сайта: https://example.ru/robots.txt. По RFC 9309, для каждого хоста, протокола и порта действует свой файл, поэтому у поддомена должен быть собственный. Яндекс требует имя robots.txt, ответ HTTP 200 и размер не больше 500 КБ; файл, который этим требованиям не отвечает, Яндекс считает разрешением индексировать всё. Google читает первые 500 KiB, остальное отбрасывает.
Файл состоит из групп. Группа начинается одной или несколькими строками User-agent, после них идут Allow и Disallow. Робот выбирает группу со своим именем, без учёта регистра; несколько групп для одного имени объединяются; нет такой группы — применяется User-agent: *. Внутри группы побеждает самое длинное совпадение с путём, при равенстве выигрывает Allow. Настройка robots.txt под ИИ-роботов сводится к одному из трёх вариантов.
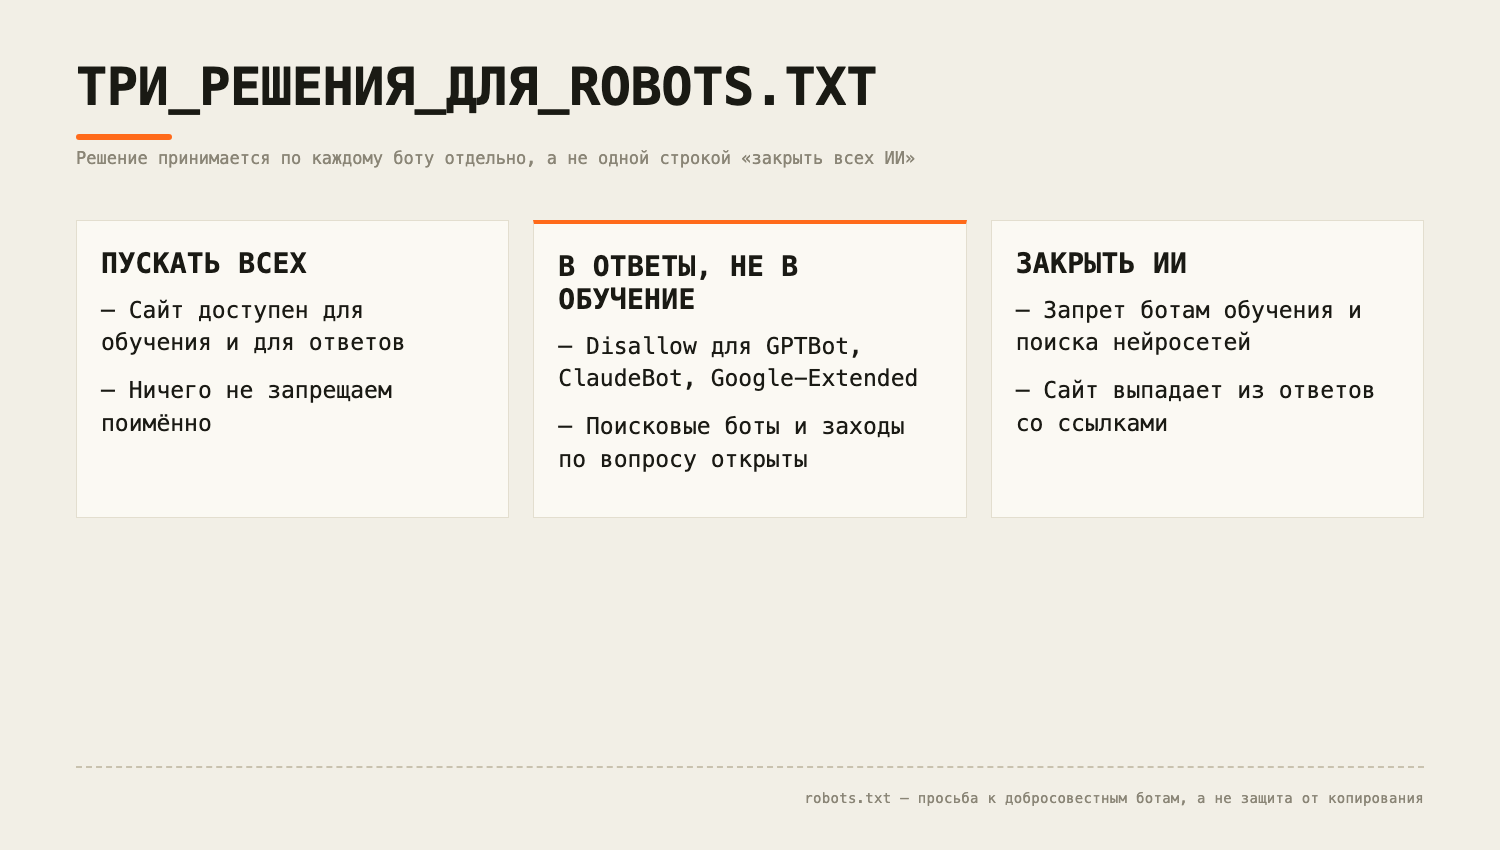
Вариант 1. Открыть сайт всем роботам. Подходит, если нужна видимость везде, а обучение моделей не беспокоит.
User-agent: *
Allow: /

Sitemap: https://example.ru/sitemap.xml
Вариант 2. Пускать в ответы, но не в обучение. Роботы обучения закрыты, поисковые роботы нейросетей остаются под общим правилом.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Meta-ExternalAgent
Disallow: /

User-agent: *
Allow: /

Sitemap: https://example.ru/sitemap.xml
Правило после нескольких строк User-agent действует на каждого из перечисленных. Закрытый Google-Extended отключает и обучение Gemini, и подстановку страниц в Gemini Apps. У Apple своя оговорка: отказ от Applebot-Extended не отключает использование данных Applebot в ответах Siri и Search, для этого нужен метатег nosnippet.
Вариант 3. Закрыть всё, что относится к ИИ. Основные поисковые роботы Google и Яндекса здесь не тронуты, иначе сайт пропадёт из обычной выдачи.
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: Google-Extended
User-agent: YandexAdditional
User-agent: YandexAdditionalBot
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Meta-ExternalAgent
User-agent: Meta-WebIndexer
Disallow: /

User-agent: *
Allow: /

Sitemap: https://example.ru/sitemap.xml
Третий вариант оставляет сайт в поиске Google и Яндекса, но убирает его из ответов ChatGPT, Claude, Perplexity и Алисы AI; Anthropic прямо предупреждает о снижении видимости. Закрыть только раздел можно строкой Disallow: /private/ вместо Disallow: /. Кириллицу в robots.txt Яндекс не принимает: домены пишут в Punycode, пути в процентной кодировке. Директиву Crawl-delay Яндекс не учитывает с 22.02.2018 (скорость обхода задаётся в Вебмастере), Google её не поддерживает, а Anthropic поддерживает.
Синтаксис проверяет «Анализ robots.txt» в Вебмастере Яндекса: инструмент находит ошибки и противоречия и показывает, какие страницы разрешены. Он работает и для сайта, который в Вебмастер не добавлен. Следом стоит открыть логи сервера: роботы OpenAI при запросе самого файла могут добавлять в User-Agent маркер robots.txt, по нему видно, что файл прочитан.
Строка User-Agent в логе сама по себе ничего не доказывает, её легко подделать. Яндекс прямо пишет, что роботы могут маскироваться под его роботов, Common Crawl тоже знает о поддельных CCBot. Настоящих роботов отличают по адресу. OpenAI публикует диапазоны IP в gptbot.json, searchbot.json и chatgpt-user.json, Perplexity в perplexitybot.json и perplexity-user.json, Common Crawl в ccbot.json.
Яндекс и Google советуют обратный DNS. По IP из лога узнают имя хоста: у Яндекса оно оканчивается на yandex.ru, yandex.net или yandex.com, у Google на googlebot.com. Затем прямой DNS по этому имени должен вернуть исходный IP, иначе робот поддельный. В Вебмастере Яндекса для этого есть отдельная проверка IP-адреса.
Robots.txt — просьба к роботам, а не замок. RFC 9309 говорит, что его правила не являются формой авторизации и не заменяют защиту контента. Сам файл публичен, и перечисленные в нём закрытые пути видны любому. Закрыть доступ по-настоящему можно только на сервере или в брандмауэре.
У заходов по запросу пользователя оговорки записаны в самой документации. У OpenAI для ChatGPT-User правила robots.txt могут не применяться, Perplexity-User их в целом игнорирует, Meta-ExternalFetcher может их обойти. При этом Cloudflare в тесте 04.08.2025 видел у ChatGPT-User другое поведение: робот запросил robots.txt и прекратил обход при запрете. Оговорку OpenAI это не отменяет.
Бывает и хуже. Cloudflare сообщил 04.08.2025, что на тестовых доменах, полностью закрытых в robots.txt, зафиксировал обход Perplexity под обычным браузерным User-Agent. Таких запросов было 3–6 млн в день против 20–25 млн с заявленных роботов. Это наблюдение Cloudflare; ответ Perplexity мы не разбирали.
В документации нашлись три случая, когда настройка срабатывает не так, как задумал владелец сайта.
Ошибка 5xx на запрос robots.txt. По RFC 9309, пока файл недоступен из-за ошибки сервера, краулер должен считать, что запрещено всё; если так продолжается дольше 30 дней, он может вести себя как при 4xx. Для сайта на нестабильном хостинге временный сбой на /robots.txt закрывает его от всех роботов. Ответ 4xx трактуется наоборот: файла нет, ходить можно куда угодно.
Блокировка по IP в брандмауэре. Anthropic предупреждает, что блок IP-адресов его краулеров может не дать надёжного отказа: робот не сможет прочитать robots.txt. Отказ компания просит оформлять в файле, на каждом поддомене отдельно.
Блок User-agent: *, который на часть роботов не действует. Звёздочка не касается YandexAdditional и YandexAdditionalBot, а у Яндекса ещё и роботов, которые скачивают страницы по инициативе пользователя. Для запрета им нужен блок с их именем. Ещё одна особенность Яндекса: если в файле есть группа User-agent: Yandex, роботы Яндекса блок * не читают. Если же у робота есть собственная группа, например у YandexBot, для него не действуют ни Yandex, ни *.
Отдельно о том, что запрет в robots.txt не убирает страницу из поиска Яндекса: закрытые там страницы могут участвовать в выдаче. Чтобы убрать страницу из поиска, нужен noindex в HTML или в HTTP-заголовке, а в robots.txt её при этом не закрывают.
Открытый robots.txt даёт роботу право зайти, но не гарантирует, что он увидит текст. Если содержимое страницы собирается JavaScript-ом только в браузере, поисковый робот получит вместо сайта пустой каркас. Если CDN или хостинг режет незнакомые User-Agent, робот не дойдёт даже до файла: Google в документации отдельно напоминает, что обход нужно разрешить и в robots.txt, и на уровне CDN.
Проверка короткая. Откройте страницу с отключённым JavaScript или запросите её через curl и убедитесь, что основной текст на месте. Затем посмотрите в логах, получают ли роботы HTTP 200 и на страницы, и на robots.txt. Подробный разбор причин — в статье почему ИИ не видит сайт. Для Яндекса полезен ещё отчёт Вебмастера об Алисе AI: он показывает упоминания по запросам, где сайт уже высоко в выдаче. Файл llms.txt ссылок из ответов не гарантирует, его роль разобрана в статье llms.txt: что это.
Мы в Звонко пускаем ИИ-роботов поимённо: общее правило User-agent: * разрешает всё, и поверх него отдельно разрешены роботы OpenAI, Anthropic, Perplexity, Google, Apple, Common Crawl, Meta и ещё нескольких сервисов. Явные Allow: / для имён, которые и так покрыты звёздочкой, на поведение роботов не влияют. Они записывают наше решение для того, кто будет править файл, и страхуют на случай, если когда-нибудь появится общий запрет.
Список мы сверяли с документацией в конце августа и удалили из него Claude-Web и anthropic-ai: в актуальной документации Anthropic этих токенов нет. При повторной сверке 13.10.2026 нашлись две записи без подтверждения: токена YandexAI нет в Справке Яндекса, а опубликованного user-agent для GigaChat у Сбера мы не нашли. Следующий шаг — заменить запись YandexAI задокументированными YandexAdditional и YandexAdditionalBot и дописать в комментарий про Google-Extended подстановку страниц в Gemini. Замена нужна для точности файла, запрета она не добавляет: для открытого сайта блок с YandexAdditionalBot не обязателен, без запрета показ в ответах Алисы AI разрешён по умолчанию.
Правило, которое мы из этого вынесли: перед правкой robots.txt сверять имена роботов с документацией их разработчиков, а не с чужими подборками, потому что имена меняются.
ваш-сайт/robots.txt и убедитесь, что файл отвечает HTTP 200, а не ошибкой сервера.Disallow: / под User-agent: *. По каждой решите, нужна ли она: закрытый GPTBot отключает только обучение, закрытый OAI-SearchBot убирает сайт из поиска ChatGPT.Если вы решаете, каких роботов пускать на сайт, и хотите разобрать это вместе, посмотрите, как мы ведём продвижение в нейросетях, и отдельно — продвижение в ChatGPT.
Закрыли ИИ-роботов в robots.txt и не знаете, остался ли сайт в ответах нейросетей? Проверим ваш robots.txt и ответы сервера роботам и покажем, какие нейросети называют ваш бренд. Закажите диагностику AEO/GEO в Звонко или напишите нам: диагностику начинаем без предоплаты.
GPTBot — робот OpenAI, который обходит страницы для обучения генеративных моделей. Если закрыть его в robots.txt, OpenAI считает, что материалы сайта нельзя использовать для обучения. На показ сайта в ответах поиска ChatGPT это не влияет: за него отвечает отдельный робот OAI-SearchBot. Сведения сверены с документацией OpenAI 13.10.2026.
Нет, если оставить открытым OAI-SearchBot. У OpenAI две независимые настройки: GPTBot отвечает за обучение, OAI-SearchBot за показ сайтов в поиске ChatGPT. Сайты, закрытые для OAI-SearchBot, по документации не показываются в ответах поиска ChatGPT, хотя могут остаться навигационной ссылкой. После правки robots.txt системам OpenAI нужно около 24 часов.
Файл называется robots.txt и лежит в корне сайта: https://example.ru/robots.txt. Для каждого поддомена нужен свой файл. Яндекс требует ответ HTTP 200 и размер до 500 КБ, Google читает первые 500 KiB. Внутри файла правила собраны в группы: строка User-agent с именем робота, затем Allow и Disallow. Применяется самое длинное подходящее правило, при равенстве побеждает Allow.
Да. Яндекс описывает для этого роботов YandexAdditional и YandexAdditionalBot: запрет для них убирает контент из ответов Алисы AI и быстрых ответов, а в поиске сайт остаётся. Блок User-agent со звёздочкой на них не действует, поэтому нужен отдельный блок с их именами. Изменение вступает в силу за 2–14 дней.
Нет. Это просьба к роботам, а не контроль доступа: RFC 9309 прямо говорит, что правила не являются формой авторизации. Добросовестные краулеры её исполняют. Заходы по запросу пользователя у OpenAI, Perplexity и Meta в документации помечены оговоркой, что правила могут не применяться. Чтобы действительно закрыть доступ, нужны настройки сервера или брандмауэра.
Сверьте IP-адрес из лога с диапазонами, которые разработчик бота публикует в JSON: у OpenAI это openai.com/gptbot.json, у Perplexity perplexity.com/perplexitybot.json. Яндекс и Google советуют обратный DNS: имя хоста должно оканчиваться на yandex.ru, yandex.net, yandex.com или googlebot.com, а прямой DNS по этому имени должен вернуть тот же IP.
Открытый robots.txt только разрешает заход. Робот может не увидеть содержимое, если текст появляется только после выполнения JavaScript, если сервер отдаёт ему ошибку или блокирует по IP на уровне CDN и брандмауэра. Google это оговаривает отдельно: обход нужно разрешить и в robots.txt, и на уровне CDN или хостинга.
Нет, он за это не отвечает. Google-Extended управляет использованием контента для обучения Gemini и для подстановки в Gemini Apps и Vertex AI, но не влияет ни на ранжирование, ни на AI Overviews. Ограничить использование страницы в AI Overviews и AI Mode можно директивой nosnippet или data-nosnippet; цена такого решения: сниппет пропадёт и в обычной выдаче.
 GEO
Нейросеть берёт источники в два этапа: сначала поиск собирает кандидатов, потом модель отбирает фрагменты. Что подтверждено документацией и данными, что миф.
Читать статью → GEO
Генеративный поиск надстроен над индексом: вопрос дробится на подзапросы, система отбирает фрагменты страниц и пересказывает их. Как это устроено у Google, Алисы AI, ChatGPT и что делать сайту.
Читать статью → репутация в ИИ
Негатив в ответах нейросетей не удалить кнопкой: он уходит вместе с источником. Замер Звонко на 20 компаниях: шесть типов негатива и что делать с каждым.
Читать статью →Начнём с бесплатного экспресс-замера: покажем, как нейросети видят ваш бренд сейчас и где есть смысл работать.