Золотой мяч 2026: Сафонов, хоккей и споры нейросетей
Когда вручение золотого мяча 2026, кто номинанты на трофей Яшина и что нейросети говорят о шансах Сафонова — а заодно о хоккее вместо футбола.
Читать статью →llms.txt советуют GigaChat и ChatGPT, а Алиса AI, Google и Claude — нет. Что это за файл, пример, нужен ли он сайту и почему Google его не использует.
Коротко: llms.txt — markdown-оглавление сайта для ИИ-агентов. В замере Звонко его советуют GigaChat и ChatGPT, а Алиса AI (0 из 40 ответов), Google AI Overviews (0 из 35) и Claude (0 из 20) — ни разу. Google файл игнорирует, по данным Ahrefs 97% файлов за месяц никто не запросил.
Совет завести llms.txt приходит от подрядчиков, из SEO-блогов и от самих нейросетей. Последнее мы в Звонко проверили: в замерах 22 августа и 1 октября 2026 года задали нейросетям 20 вопросов о продвижении в нейросетях. Совет завести файл прозвучал в ответах на 11 из них. Поставить llms.txt можно за 15 минут, а ошибка обходится дороже: купить файл как продвижение в нейросетях и не заняться страницами, из которых нейросеть берёт ответ.
Файл llms.txt — это текстовый документ в формате markdown, который лежит в корне сайта и даёт ИИ-агенту краткое описание проекта со ссылками на главные страницы. Ближайшая аналогия — карта сайта, только написанная словами и для языковой модели. Чтобы понять, что это за llms.txt на деле, достаточно открыть файл самой спецификации на llmstxt.org. Спецификацию предложил Джереми Ховард, она опубликована 3 сентября 2024 года и изменена 10 августа 2026 года (llmstxt.org).
Единственная обязательная часть файла — заголовок H1 с названием проекта. Дальше идут необязательные blockquote с кратким описанием, текстовые блоки и разделы по H2 со списками ссылок. Каждый пункт начинается с markdown-ссылки [название](https://адрес-страницы), после неё через двоеточие можно дать пояснение.
Основное применение спецификация называет прямо: документация программного обеспечения, куда кодинг-агенты ходят за справочником API. Для бизнеса файл допускается как описание структуры и политик. Авторы ждут пользы на этапе ответа на вопрос (inference), а не обучения модели.
Минимальный llms.txt — это заголовок, описание в одну строку и список ссылок с пояснениями. Вот целиком файл самой спецификации (637 байт, llmstxt.org/llms.txt, скачан 5 октября 2026 года):
# llms.txt

> A proposal that those interested in providing LLM-friendly content add a /llms.txt file to their site. This is a markdown file that provides brief background information and guidance, along with links to markdown files providing more detailed information.

## Docs

- [llms.txt proposal](https://llmstxt.org/index.md): The proposal for llms.txt
- [Python library docs](https://llmstxt.org/intro.html.md): Docs for `llms-txt` python lib
- [ed demo](https://llmstxt.org/ed.md): Tongue-in-cheek example of how llms.txt could be used in the classic `ed` editor, used to show how editors could incorporate llms.txt in general.
Для сайта компании шаблон тот же. Так начинается файл zvonkooo.ru/llms.txt; дальше идут разделы «Услуги», «Кейсы» и другие — такие же списки ссылок с пояснениями, как в примере выше:
# Звонко

> Звонко — агентство продвижения бренда в нейросетях (AEO/GEO). Делаем так, чтобы Алиса AI, ChatGPT, Google AI Overviews, GigaChat, Claude, Perplexity и DeepSeek называли ваш бренд по запросам ниши, а не конкурентов.
Спецификация пояснение после двоеточия не требует, но мы советуем его писать: без него агенту остаётся угадывать содержание страницы по адресу.
Google официально сообщает, что его поиск файл llms.txt не использует. В руководстве «Optimizing your website for generative AI features on Google Search», раздел Mythbusting, сказано: чтобы появляться в Google Search, включая генеративные функции, не нужно создавать новые машиночитаемые файлы, текстовые файлы для ИИ, разметку или Markdown, потому что поиск ими не пользуется. Такие файлы можно делать для других сервисов, и они «neither harm nor help» видимости в Google. Страница обновлена 10 июля 2026 года (руководство Google).
Позиция не новая. Джон Мюллер 17 июня 2025 года написал в Bluesky: «FWIW no AI system currently uses llms.txt». По серверным логам, добавил он, потребительские LLM и чат-боты забирают страницы для обучения и grounding, а llms.txt не запрашивает ни один (SERoundtable). Гэри Илш в июле 2025 года на Search Central Live сказал, что Google файл не поддерживает и не планирует; это пересказ SERoundtable, запись выступления мы не открывали (SERoundtable).
В 2026 году тон остался прежним. 20 января SERoundtable описал эпизод: CMS-платформа Google стала поддерживать llms.txt, файл появился в ряде документаций Google, затем команда Search убрала его со своих страниц, а на вопрос, считать ли это поддержкой, Мюллер ответил «no» (SERoundtable). 2 июня 2026 года Search Engine Journal разобрал его ответ на Reddit, где llms.txt назван пока умозрительной идеей, а другим направлением упомянут WebMCP (Search Engine Journal).
По серверным логам четырёх независимых исследований llms.txt почти никто не запрашивает, а среди тех, кто запрашивает, ИИ-боты в меньшинстве. Ahrefs 15 июня 2026 года разобрал 137 210 доменов из Ahrefs Web Analytics за май: файл публикуют 28% доменов, и 97% этих файлов за месяц не получили ни одного запроса (Ahrefs).
Среди запросов, которые файлы всё же получили, ИИ-боты дали 19,5%, инструменты SEO-аудита — 21,7%. Остальное пришлось на неопознанные источники (14,9%), обычные веб-краулеры (13,1%), профайлеры технологий (11,6%), GEO/AEO-сканеры (5,8%), людей (4%) и прочих.
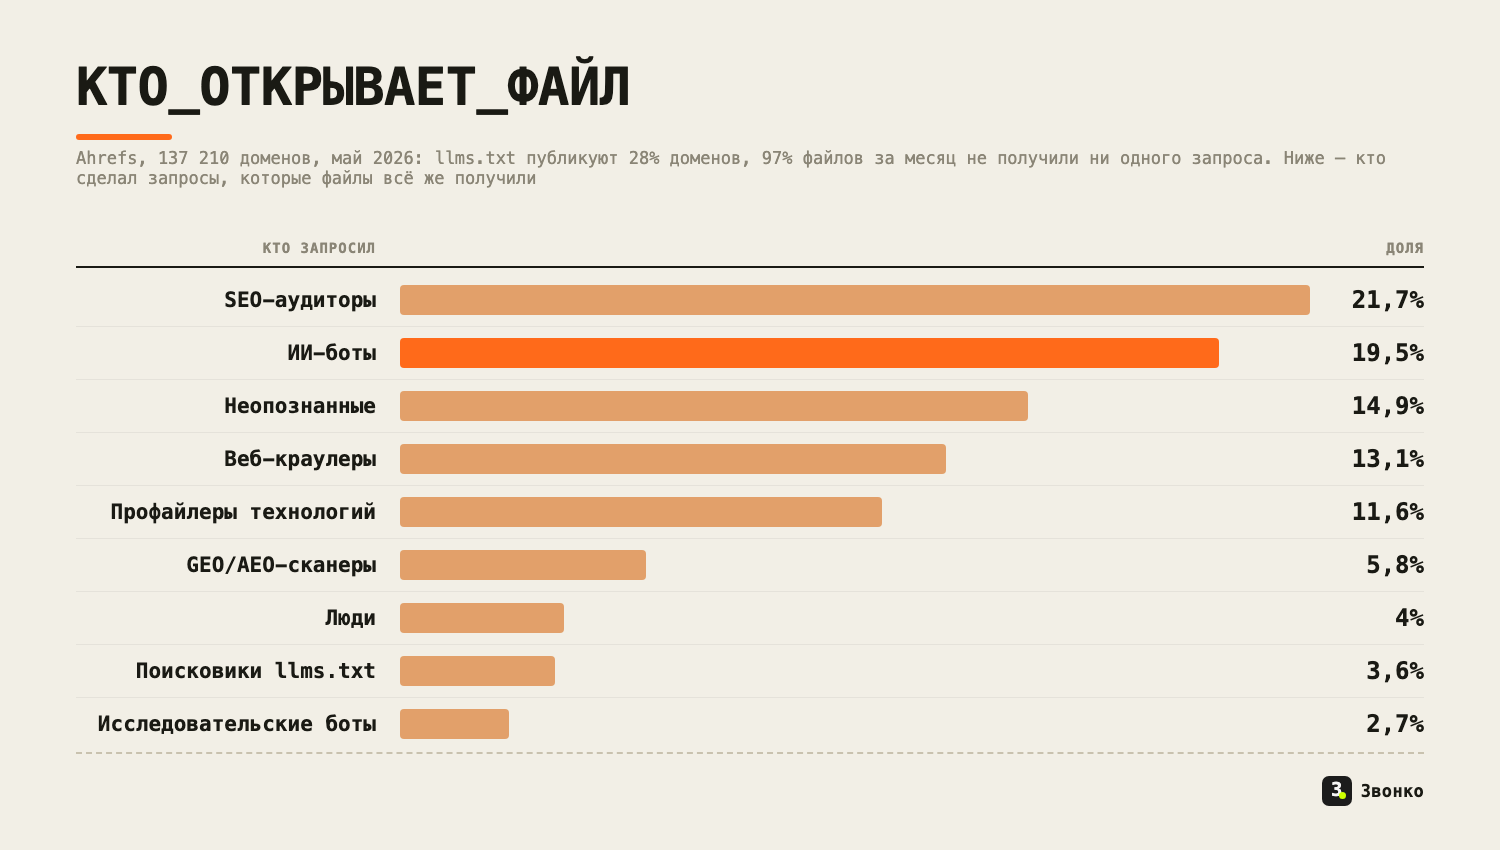 Источник: Ahrefs, исследование llms.txt по 137 210 доменам, 15.06.2026. Доли — от запросов, которые файлы всё же получили в мае 2026 года.
Limy в 2026 году следил за трафиком ИИ-ботов (GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot, Google-Extended) в 90-дневном окне: из 515 382 577 событий к llms.txt напрямую обратились 408, около 0,00008% (пересчёт наш). Limy оговаривается, что IDE-агенты вроде Cursor и Claude Code файл запрашивают, но данных об этом в исследовании нет (Limy).
OtterlyAI за 90 дней на тестовом сайте получил 84 обращения к файлу из более чем 62 100 визитов ИИ-ботов (0,1%), а средняя страница сайта — около 265 визитов (OtterlyAI). SE Ranking проверил почти 300 000 доменов: файл есть у 10,13%, корреляции между ним и числом цитирований в ИИ нет, а без этой переменной точность модели XGBoost даже выросла (SE Ranking).
Противоположное свидетельство одно: Рэй Мартинес показал в логах, что OpenAI обращается к его llms.txt на нескольких сайтах каждые 15 минут (SERoundtable, 24.07.2025). Это один специалист без описания метода, и на весь рынок мы такой случай не переносим.
Официального заявления о том, что продукты OpenAI, Anthropic, Perplexity или Яндекса читают llms.txt при ответе, мы не нашли; проверяли по документации ботов этих компаний. OpenAI и другие лаборатории публикуют llms.txt для своих документаций для разработчиков, но это не значит, что ChatGPT читает чужие файлы (страница OpenAI о краулерах).
У Яндекса официальный механизм управления использованием контента в ответах ИИ — robots.txt и токены YandexAdditional и YandexAdditionalBot (справка Яндекса). О поддержке llms.txt в Алисе AI в справке ничего нет.
В замере Звонко совет завести llms.txt дают четыре нейросети из семи, а Алиса AI, Google AI Overviews и Claude не дают его ни разу. Мы задали 20 вопросов о продвижении в нейросетях и получили 255 ответов (логи от 22 августа и 1 октября 2026 года). Совет прозвучал в ответах на 11 вопросов из 20. Больше всего таких ответов у GigaChat — 8 из 40, по доле впереди DeepSeek — 4 из 17. У ChatGPT таких ответов 7 из 63, у Perplexity — 1 из 40. У Алисы AI их 0 из 40, у Google AI Overviews — 0 из 35, у Claude — 0 из 20.
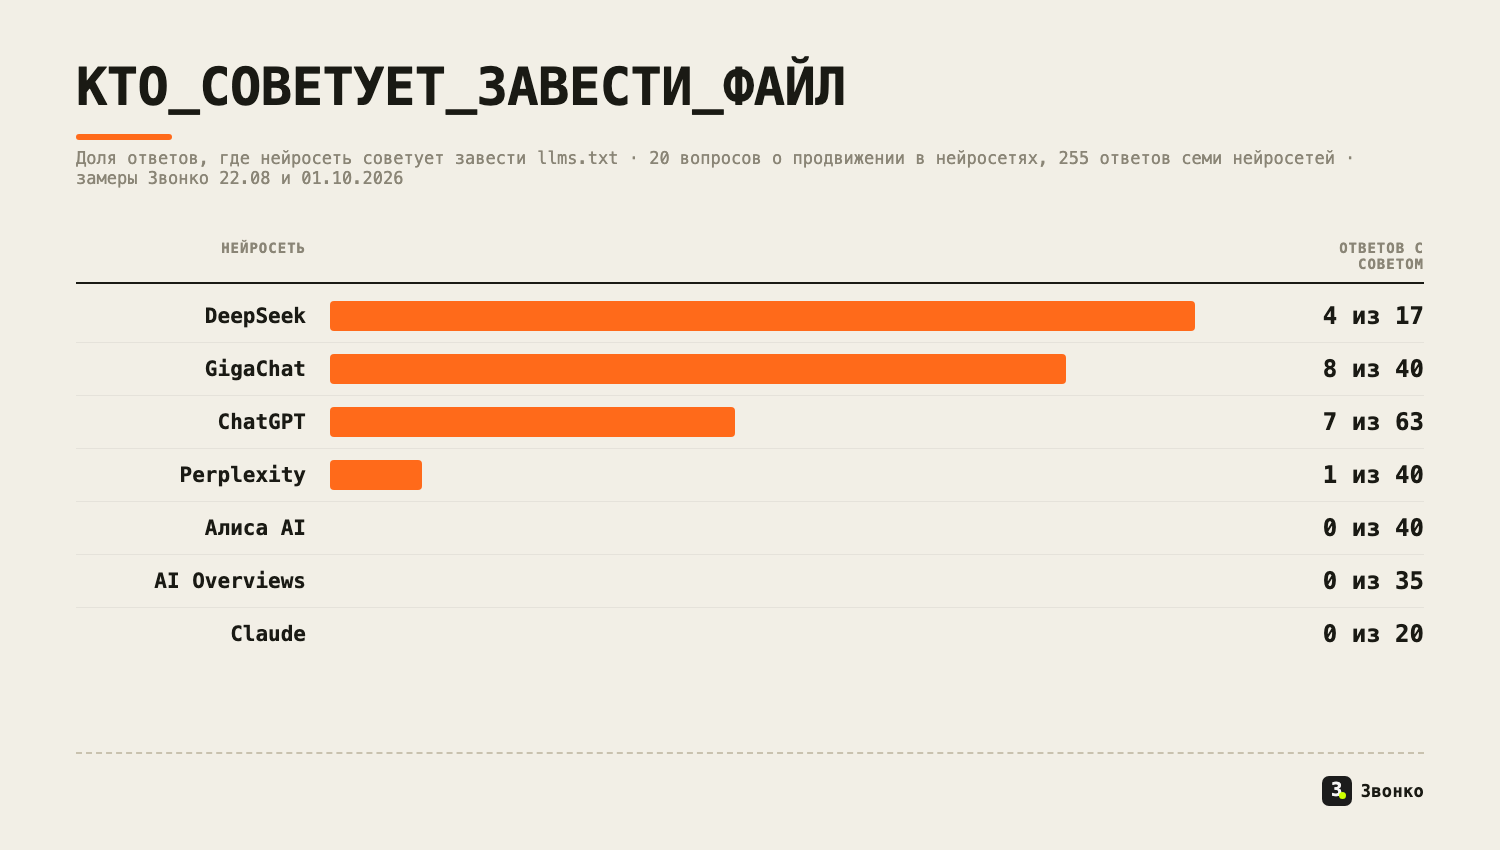 Источник: замеры видимости Звонко 22.08 и 01.10.2026, 20 вопросов о продвижении в нейросетях, 255 ответов семи нейросетей.
Почему так, мы не проверяли. Рабочая гипотеза: про llms.txt написано много статей, и модель повторяет частое, а проверять по логам не умеет. Для решения важнее другое: совет ChatGPT или GigaChat не доказывает ни того, что файл читают, ни того, что он поднимает сайт в ответах.
Файл llms.txt есть почти у всей зарубежной документации для разработчиков и почти ни у кого из крупных российских сайтов. В замере Звонко от 2 сентября 2026 года из 32 проверенных доменов файл отдают 23. У зарубежной документации он есть на 21 из 23 доменов (Anthropic, Stripe, Cloudflare, Vercel, OpenAI, Perplexity, Mistral и другие). У крупных российских сайтов — на 1 из 8, у bitrix24.ru. У tilda.cc, amocrm.ru, vc.ru, habr.com и developers.sber.ru файла нет, а cloud.ru/docs вместо него отдаёт HTML-страницу.
Размер у этих файлов разный на порядок: у docs.anthropic.com — 73 393 байта, у vercel.com/docs — 3 507 байт, и оба оглавления выполняют свою задачу. Длина файла ничего не говорит о его пользе, важнее, чтобы ссылки вели на нужные страницы и были понятно подписаны.
Нужен ли llms.txt сайту, зависит от одного вопроса: ходят ли к нему программы-агенты за справочной информацией. У документации и сервисов с API такие читатели есть, у магазинов, локального бизнеса и B2B-услуг доказанных пока нет. Если плагин собирает файл сам, его можно включить у любого сайта, но ждать от него роста в нейросетях не стоит.
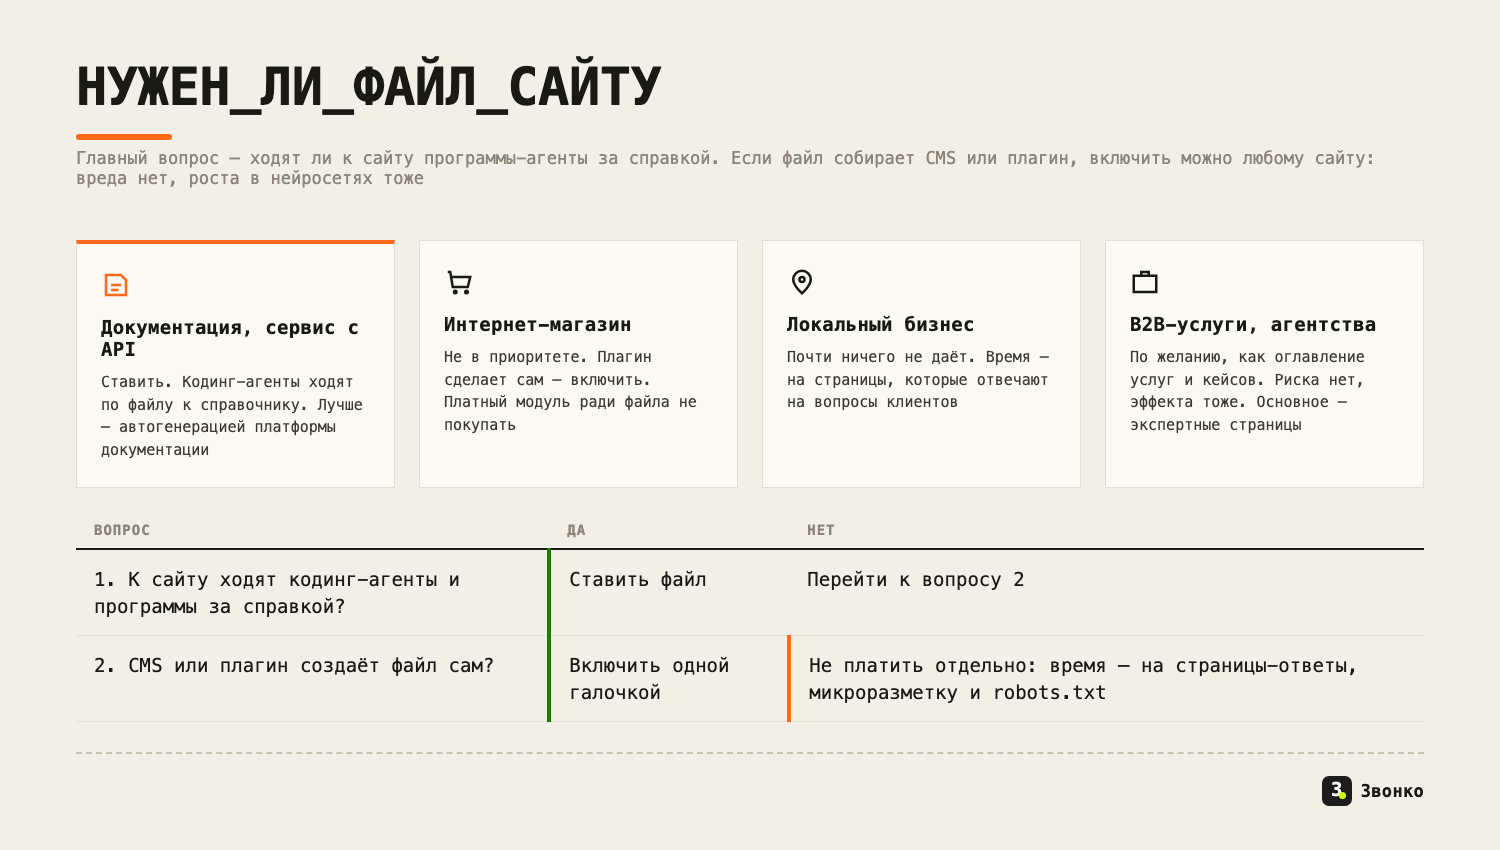 Схема Звонко по спецификации llmstxt.org и руководству Google для генеративного поиска (обновлено 10.07.2026).
Документации и сервисам для разработчиков файл нужен в первую очередь: спецификация называет их главным применением, а 21 из 23 проверенных Звонко зарубежных документаций его уже публикуют. Chrome Lighthouse в категории «Agentic browsing audits» проверяет наличие файла, но называет его «emerging convention»: при 404 аудит получает статус Not Applicable, так как файл пока необязателен (документация Chrome). Это про удобство агентов-браузеров, а не про Google Search.
Магазину файл в приоритет не входит: данных о том, что нейросети берут из него ответы о товарах, нет. Если магазин на WordPress, Yoast SEO и Rank Math создают файл сами, и включить его можно за минуту. В ядре Битрикса нативной поддержки мы не нашли, есть сторонний платный модуль «Сотбит: Карта сайта для ИИ», и покупать его ради файла смысла мало.
Клинике, салону или автосервису файл почти ничего не даёт: на таком сайте десяток страниц, и агенту хватит самого сайта. Файл можно поставить за пять минут, но время полезнее потратить на страницы, которые прямо отвечают на вопросы клиентов. Платить подрядчику за llms.txt здесь не нужно.
Компании с B2B-услугами могут поставить файл как описание структуры: услуги, кейсы, цены, контакты. Google пишет, что файл не навредит и не поможет в его поиске, поэтому риска нет, как нет и эффекта. Мы в Звонко держим llms.txt на zvonkooo.ru как оглавление услуг и кейсов и рост упоминаний ему не приписываем. Основные силы в B2B уходят на экспертные страницы, кейсы и сравнения; как мы выстраиваем такую работу, описано на странице GEO/AEO-продвижения.
За сам llms.txt отдельно платить не стоит: файл собирается за 15 минут вручную или одним кликом в плагине, а доказанного эффекта от него нет. Если подрядчик включает файл в работу над структурой сайта, это нормальный пункт сметы на час-два. Если он продаёт llms.txt как продвижение в нейросетях и обещает рост упоминаний, задайте ему три вопроса.
Первый: какой замер видимости в нейросетях сделан до работ и будет сделан после, по каким вопросам и в каких нейросетях. Второй: что кроме файла входит в работу — страницы, разметка, доступ ботов в robots.txt. Третий: откуда уверенность, что файл читают важные для вашего бизнеса нейросети, если для Google руководство 2026 года говорит обратное, а для Алисы AI заявления нет. Подрядчик, у которого на эти вопросы есть цифры, обычно предлагает больше, чем файл.
В robots.txt ссылаться на llms.txt не нужно: директивы для этого нет, и файлы решают разные задачи. По спецификации robots.txt сообщает автоматическим инструментам, какой доступ к сайту допустим, а llms.txt используется по требованию, когда агенту нужны сведения по теме. Файл «может дополнять robots.txt, давая контекст для разрешённого контента», но доступом не управляет (llmstxt.org).
Пустить ИИ-ботов на сайт или закрыть его от них можно только через robots.txt. Токены и назначение ботов по их документациям:
| Бот | Компания | Что делает |
|---|---|---|
| GPTBot | OpenAI | сбор данных для обучения моделей |
| OAI-SearchBot | OpenAI | поиск ChatGPT |
| ChatGPT-User | OpenAI | переходы по запросу пользователя, правила robots.txt могут не применяться |
| ClaudeBot | Anthropic | обучение |
| Claude-SearchBot | Anthropic | поиск |
| Claude-User | Anthropic | переходы по запросу пользователя |
| PerplexityBot | Perplexity | поиск, не обучение |
| Perplexity-User | Perplexity | запрос пользователя, обычно игнорирует robots.txt |
| Google-Extended | обучение Gemini и grounding в Gemini Apps; на включение в Google Search не влияет | |
| YandexAdditional, YandexAdditionalBot | Яндекс | использование контента в ответах ИИ Яндекса |
Настройки OpenAI независимы друг от друга, а после правки robots.txt поиску нужно около 24 часов (OpenAI). Anthropic поддерживает нестандартную директиву Crawl-delay (Anthropic), Perplexity описывает ботов в своей документации, для Google-Extended есть страница краулеров. У Яндекса запрет через Disallow для YandexAdditional вступает в силу после переобхода, обычно через 2–14 дней.
Вторая версия спецификации от 10 августа 2026 года добавила подпути, второй способ именования markdown-страниц и стандартные заголовки обнаружения, а инструмент llms_txt2ctx убрала. Файл теперь может лежать в /llms.txt или в подпути вроде /docs/llms.txt: он покрывает адреса под своим путём, а при нескольких файлах применяется самый специфичный (список изменений).
Markdown-версию страницы можно назвать двумя способами: дописать .md к полному адресу (page.html.md, как в первой версии) или заменить расширение (page.md). Для обнаружения предлагаются связи rel="alternate" type="text/markdown" и rel="describedby" в HTML или в HTTP-заголовке Link:, который добавляется на уровне сервера или CDN без правки страниц.
Файлы llms.txt и llms-full.txt часто упоминают вместе, но второго в спецификации нет: на обеих страницах стандарта строки «llms-full» не встречается. Это соглашение сторонних генераторов, полный текст страниц одним файлом. Вторая версия его не убирала, ушёл только llms_txt2ctx вместе с особым смыслом раздела Optional; сам раздел остаётся как соглашение о второстепенных ссылках. По замеру Звонко от 2 сентября 2026 года медиана llms-full.txt у 16 проверенных сайтов — 715 786 токенов; подробнее в разборе про llms-full.txt.
Создать файл llms.txt можно за 15 минут: достаточно текстового редактора и списка главных страниц. По порядку:
/llms.txt.curl -I https://ваш-сайт/llms.txt: нужен код 200 и тип text/plain, а не HTML-страница, которую многие движки отдают на любой несуществующий адрес.Автоматические варианты есть в популярных CMS. Генератор в Yoast SEO анонсирован 2 июня 2025 года, работает в бесплатной версии одним кликом и, по блогу Yoast от 10 июня 2025 года, обновляется раз в неделю (Yoast). В Rank Math версия 1.0.279 от 22 сентября 2026 года привела вывод в соответствие с последней редакцией спецификации (changelog Rank Math). Для любого сайта есть бесплатный генератор llms.txt от Звонко.
На российских конструкторах картина разная. Для Битрикса встроенной поддержки в ядре нет, есть платный модуль «Сотбит». На Тильде, по сообщениям пользователей, в настройках сайта появились поля llms.txt и llms-full.txt, но в справке Тильды мы их не нашли. Пошаговая инструкция — в статье про llms.txt на Тильде и Битриксе.
Видимость в нейросетях зависит от того, найдут ли вас на шаге поиска и удобно ли цитировать вашу страницу, а не от служебного файла. Нейросеть с поиском собирает ответ из найденных документов, механизм подробно описан в материале про RAG. Если сайт не попадает в источники, оглавление ему не поможет.
Порядок такой. Сначала убедитесь, что нейросеть вообще видит страницы: причины, по которым сайт выпадает, собраны в статье почему ИИ не видит сайт. Затем дайте страницам прямые ответы на вопросы клиентов и добавьте микроразметку для нейросетей. После этого проверьте, называют ли вас в ответах: как попасть в ответы ChatGPT, разобрано в отдельной статье, а замер по вашей нише и план работ входят в GEO/AEO-продвижение под ChatGPT.
Итог для решения простой. Если файл занимает 15 минут или включается в плагине, ставьте его и не ждите от него роста. Если llms.txt продают как продвижение в нейросетях, сверьте обещание с руководством Google и логами Ahrefs и начните с замера: какие нейросети называют ваш бренд сейчас и на какие сайты они ссылаются.
llms.txt стоит, а нейросети называют конкурентов?
Покажем, какие нейросети называют ваш бренд и на какие сайты ссылаются. Диагностику начинаем без предоплаты.
Замер видимости в Звонко →Это текстовый файл в формате markdown в корне сайта: название проекта, короткое описание и список ссылок на главные страницы с пояснениями. Его предложил Джереми Ховард 3 сентября 2024 года как оглавление сайта для ИИ-агентов. Обязательна только первая строка с заголовком H1. Файл не закрывает и не открывает сайт для ботов, этим занимается robots.txt.
Нет. В официальном руководстве Google по генеративным функциям поиска, обновлённом 10 июля 2026 года, сказано, что поиск такие файлы не использует и они не помогают и не вредят видимости. Джон Мюллер ещё в июне 2025 года писал, что ни одна ИИ-система не использует llms.txt, а в 2026 году назвал идею пока умозрительной.
Доказательств нет. SE Ranking по выборке почти 300 000 доменов не нашёл связи между наличием файла и числом цитирований в ИИ. OtterlyAI за 90 дней получил 84 обращения к файлу из более чем 62 100 визитов ИИ-ботов. Официальных заявлений OpenAI, Anthropic или Perplexity о том, что их продукты читают llms.txt, мы не нашли.
Нет. Директивы для ссылки на llms.txt из robots.txt в спецификации нет. Файлы решают разные задачи: robots.txt сообщает ботам, какой доступ к сайту допустим, а llms.txt даёт агенту справку по запросу. Открыть или закрыть сайт для GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended и YandexAdditional можно только в robots.txt.
llms.txt — оглавление со ссылками, а llms-full.txt — это полный текст страниц в одном файле. Второго файла в спецификации нет: это соглашение сторонних генераторов. По замеру Звонко 02.09.2026 медиана llms-full.txt у 16 проверенных сайтов составляет 715 786 токенов, поэтому такие файлы вряд ли помещаются в контекст целиком.
Соберите список главных страниц, напишите H1, описание в одну-две строки и разделы со ссылками, затем положите файл в корень сайта по адресу /llms.txt. Для WordPress есть генераторы в Yoast SEO и Rank Math, а бесплатный инструмент Звонко на zvonkooo.ru собирает файл по адресу сайта. Проверьте, что сервер отвечает кодом 200 и типом text/plain, а не HTML-страницей.
 AEO
Когда вручение золотого мяча 2026, кто номинанты на трофей Яшина и что нейросети говорят о шансах Сафонова — а заодно о хоккее вместо футбола.
Читать статью → AEO
Спросили несколько нейросетей, где купить iPhone 18 Pro в России: Google зовёт в крупные сети, Алиса AI — в небольшие магазины, а ChatGPT перепутал страну и посоветовал Польшу.
Читать статью → GEO
llms-full.txt — весь текст сайта одним файлом. Скачали его с 32 доменов и посчитали вес: медиана 716 тысяч токенов. Кому файл нужен, а кому хватит llms.txt.
Читать статью →Начнём с бесплатного экспресс-замера: покажем, как нейросети видят ваш бренд сейчас и где есть смысл работать.