Как создать контент-завод на n8n: 9 шагов и где ломается
Как создать контент завод на n8n и нейросетях: девять шагов с узлами, тарифы и цены API, места поломок и то, что сценарий не сделает сам: проверку фактов, пороги и редактора.
Читать статью →Какие SEO-задачи отдать нейросети: группировку запросов, разбор выгрузки краулера, черновики и разметку. Где модель подменяет частоты и аудит и когда Google считает ИИ-тексты спамом.
Коротко: нейросеть ускоряет SEO-работу, но ошибка в частотах, аудите или массовых текстах стоит позиций сайта. Отдавать ей стоит задачи, где результат быстро сверяется с данными: группировку запросов, разбор отчёта по обходу сайта, черновик по ТЗ, разметку. Частоты, позиции и поток страниц без редактора остаются за людьми и данными.
Допустим, SEO-специалист вставляет в ChatGPT, Гигачат или Алису AI адрес сайта и просит найти технические ошибки. Через минуту приходит уверенный список: дубли title, медленная загрузка, нет микроразметки. Мы в Звонко пишем SEO-тексты для клиентов на конвейере с нейросетями и сверили свою практику с документацией Google и Яндекса и с открытыми тестами моделей. Модель хорошо раскладывает переданные ей данные. Частоты запросов, позиции и содержимое незнакомых ей страниц она додумывает. Такой список ошибок может описывать типичный сайт вместо вашего, и правки по нему уйдут не туда. Как мы держим качество, когда модель пишет тексты потоком, разобрано ниже, в разделе о конвейере, и в кейсе SEO-конвейера.
Нейросети выгодно отдавать задачу, если проверить результат быстрее, чем сделать работу руками. Такая проверка есть у этих задач:
Google в руководстве по использованию генеративного ИИ называет полезными применениями исследование темы и структуру собственного материала и там же просит вручную проверять весь ИИ-контент перед публикацией. На той же странице сказано, что генеративные модели не достают факты, а предсказывают вероятную последовательность слов. Anthropic в документации Claude пишет, что приёмы вроде разрешения признать незнание и опоры на цитаты заметно снижают, но не устраняют неверные ответы.
Похожую картину дал эксперимент Dell’Acqua и соавторов на 758 консультантах (Organization Science, 2026). На задачах, которые модель выполняет хорошо, участники с ИИ работали на 25,1% быстрее. На задачах за пределами её возможностей они решали верно на 19 процентных пунктов реже.
Мы в Звонко сделали из этого рабочее правило: задачу, результат которой нечем проверить, модели не отдаём. Тот же тест проходит любой сео ИИ-инструмент, от чата до модуля в краулере. Тот же критерий для маркетинговых задач разобран в статье про нейросети для маркетинга.
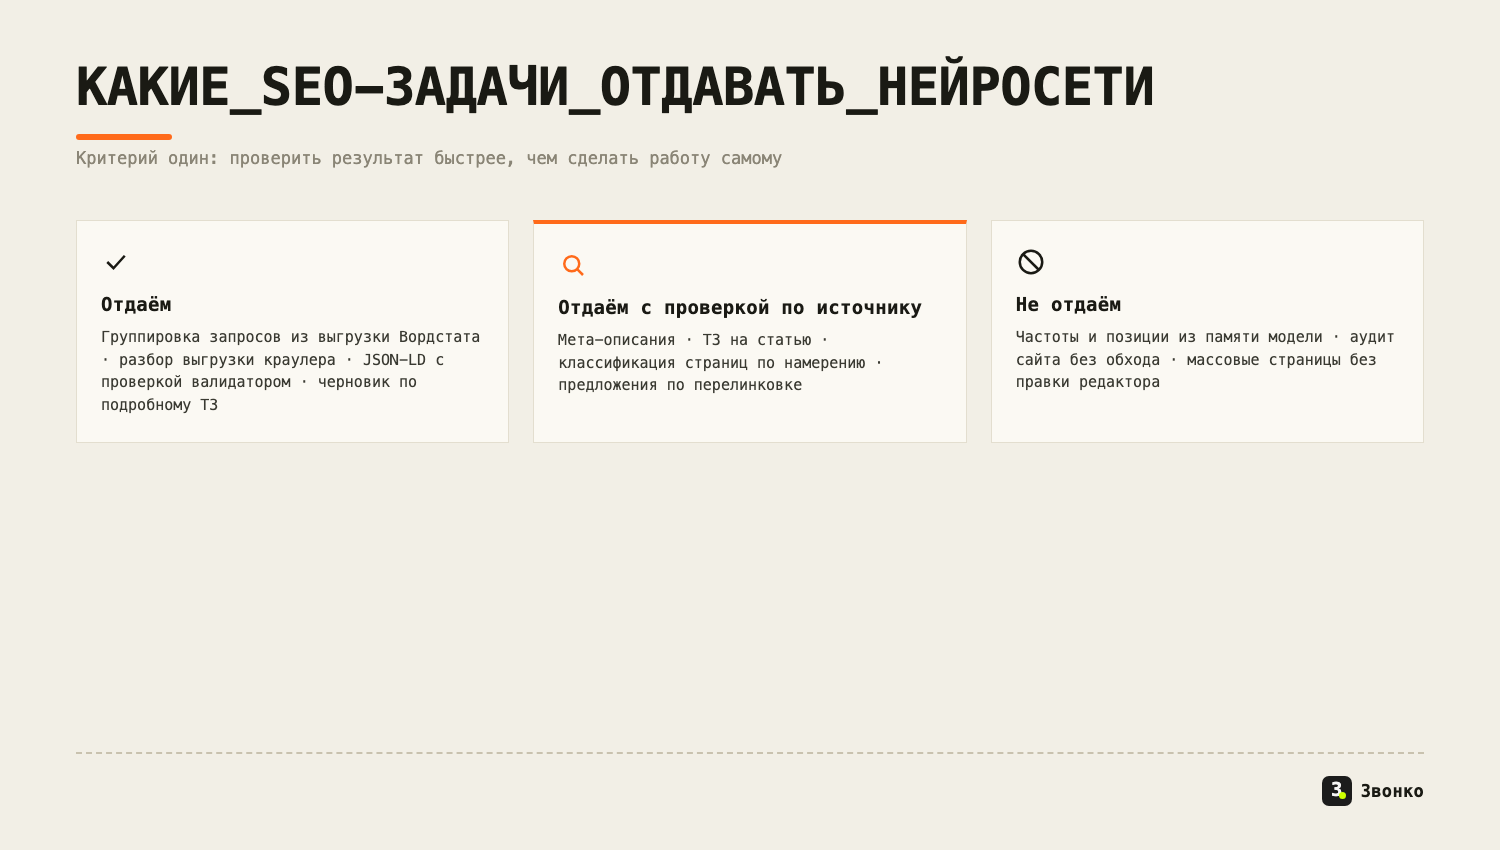
Критерий один: проверить результат быстрее, чем сделать работу.
Группировку готового списка запросов доверить можно, если её проверять, а частоты запросов брать у модели нельзя. Dejan в мае 2025 года попросил Gemini оценить объём запросов и сравнил ответы с показами в Search Console (Dejan). Запросы в тесте делили на пять корзин по объёму, и точную корзину модель назвала в 35% случаев. Размер выборки и версия модели не раскрыты. Автор теста считает, что инструмент годится для идей и аналитику не заменяет.
Отсюда практика Звонко: у модели просим уровни спроса (высокий, средний, низкий), а числа берём в Вордстате. В тесте GPT-4o на vc.ru в 2024 году модель назвала высокочастотными запросы «домен для сайта» и «облачный хостинг», хотя по Вордстату соседние «купить домен» и «арендовать сервер» популярнее. Полное семантическое ядро, то есть список запросов, под которые продвигается сайт, модель собрать не смогла. GPT-4o с тех пор устарела, но совет сверять все ключи от нейросети с Вордстатом дают и практики Callibri.
Модель группирует запросы по смыслу, а поисковик объединяет их по тому, какие страницы он показывает по каждому. В том же тесте vc.ru «лучший веб-хостинг» и «дешёвый хостинг» попали в один кластер, хотя выдача у них разная. Keyword Insights сравнил инструменты кластеризации на 216 ключевых словах. ChatGPT получил 47 баллов из 100, а ряд инструментов на данных выдачи набрал 70–89. Издатель сам продаёт такой инструмент, а ChatGPT тестировали без данных выдачи. Независимого теста на русском мы не нашли, поэтому кластеры от модели в Звонко считаем черновиком и сверяем с топ-10.
Нейросеть для анализа сайта работает с тем, что ей передали, и без выгрузки обхода сайт целиком не видит. Здесь стоит различать две ситуации.
Первая: краулеры моделей, то есть боты, которые сами обходят сайты. По данным Vercel и MERJ за декабрь 2024 года, краулеры ChatGPT и Claude не исполняют JavaScript. Файлы скриптов они загружают, но текст, который собирается в браузере, прочитать не могут. На сайте, где содержимое страницы собирает JavaScript, такой бот видит пустую оболочку. Gemini работает на инфраструктуре Google и страницы отрисовывает полностью.
Вторая: вы даёте ссылку на страницу в чате. Данные Vercel и MERJ описывают ботов, а не эту загрузку, и открытого замера того, что видит модель по такой ссылке, мы не нашли. Если страницу она загружает тем же способом, ИИ для анализа сайтов получит пустую оболочку, но это наше допущение, а не проверенный факт.
Данным Vercel почти два года, поведение ботов могло измениться, поэтому проверять стоит исходный HTML своего сайта: есть ли в нём текст, который должен увидеть бот. Открытых замеров точности ИИ-аудитов мы в Звонко не нашли, так что к обещанной в рекламе точности такого аудита стоит относиться осторожно.
Надёжнее схема, в которой сайт обходит краулер, а модель разбирает его выгрузку. Screaming Frog с версии 22.0 умеет через OpenAI, Gemini или Ollama строить эмбеддинги страниц, то есть числовые описания смысла текста. По ним программа оценивает сходство страниц по шкале от 0 до 1 и находит страницы, которые выбиваются из темы сайта. В руководстве по запросам к ИИ во время обхода разработчик сам призывает к осторожности: мета-описания от модели генерировать с оглядкой, классификацию страниц по намерению (коммерческая или информационная) внимательно просматривать.
Search Console тестирует экспериментальную функцию для ограниченного круга сайтов: фильтры отчёта собираются из запроса обычным языком. Google при этом предупреждает, что ИИ может неверно понять запрос, и фильтры нужно проверять. Почему ИИ-боты не видят часть сайтов и что с этим делать, мы разобрали в статье почему ИИ не видит сайт.
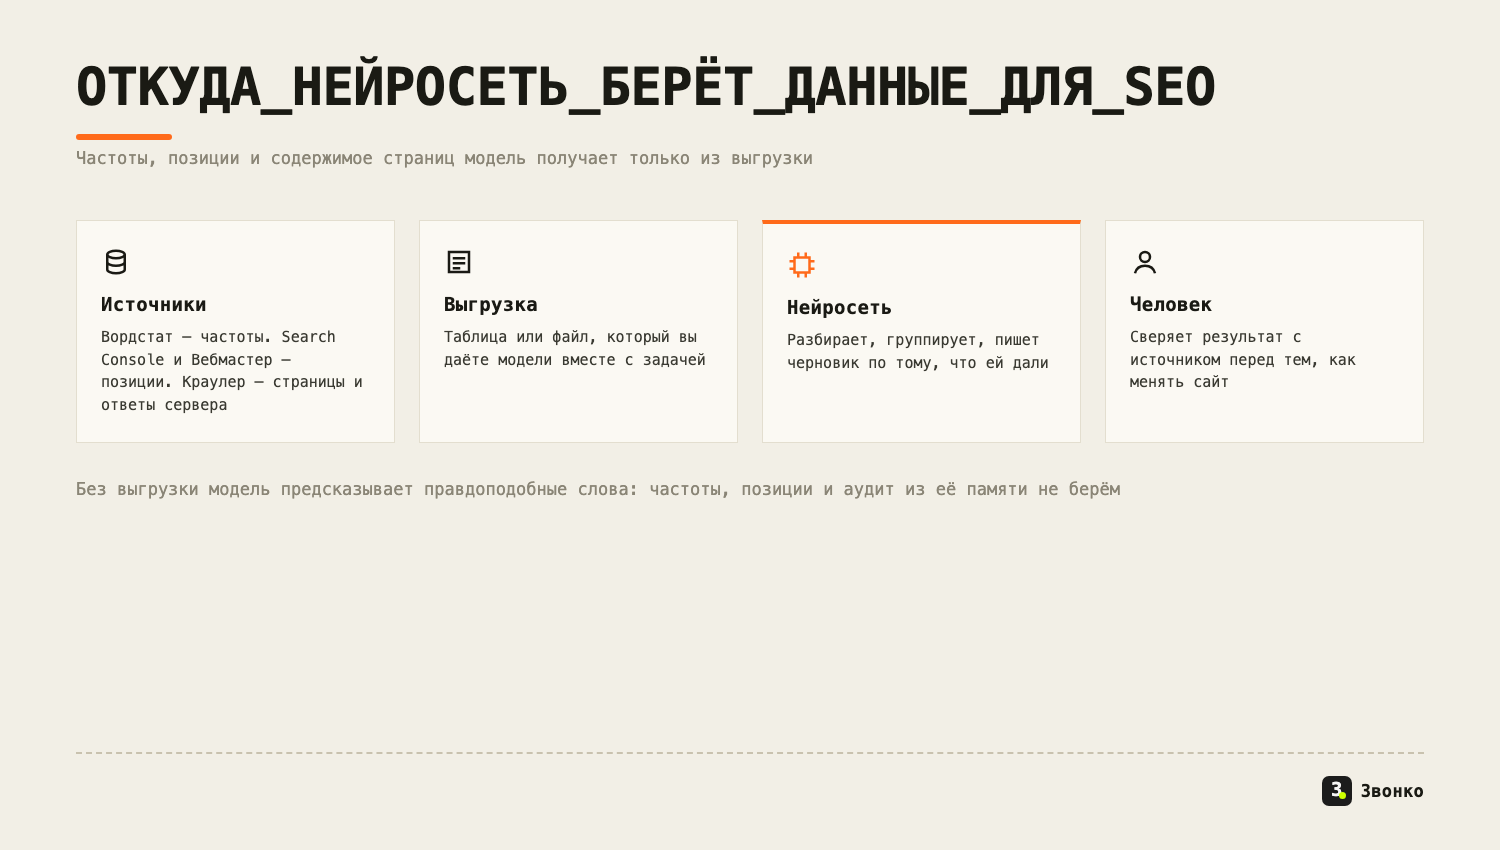
Частоты, позиции и содержимое страниц модель получает только из выгрузки.
Нейросети для SEO-текстов вредят позициям, когда страницы выпускают массово ради выдачи и без пользы для читателя. Google в политике о спаме называет это злоупотреблением масштабом (scaled content abuse): создание многих страниц с главной целью манипулировать ранжированием. Среди примеров нарушений там названа генерация многих страниц ИИ-инструментами без добавленной ценности для пользователей. Способ создания в определении критерием не назван, речь о масштабе и цели. Сайты-нарушители могут опуститься в выдаче или пропасть из неё.
Ahrefs в июле 2026 года разобрал топ-10 по 100 000 выдач (исследование Ahrefs). На позициях 1–3 только 5,3% страниц написаны целиком ИИ. У 82,2% страниц там доля ИИ ниже половины. Это корреляция: детектор доли ИИ неидеален, и о причине выборка ничего не говорит.
Сентябрьское обновление Google против спама шло с 24 сентября по 8 октября 2026 года и, по пересказу ppc.land, новых правил не принесло. Что именно оно затронуло, Google не раскрыл. Лили Рэй 28 сентября увидела первые признаки удара по шаблонным программным страницам, но это было предположение по первым дням (Search Engine Roundtable).
Справка Яндекс Вебмастера об ЭПОС (экспертность, полезность, оригинальность, содержательность) не запрещает нейросети: они могут помогать автору, но не должны его подменять. Как пример слабого контента справка приводит текст, сгенерированный ИИ на основе существующих материалов без дополнительной ценности. Как строить SEO-текст по брифу, мы разобрали в статьях про SEO-тексты и как написать текст нейросетью.
Когда сео нейросеть пишет мета-теги и микроразметку, результат легко проверить глазами и валидатором. У title есть особенность: Google не обязан его показывать. Поисковик собирает заголовок ссылки из нескольких источников и может заменить исходный, если тот частично пустой, устаревший, неточный или шаблонно повторяется. По исследованию Zyppy на 80 959 заголовках Google переписал 61,6%. Реже всего менялись заголовки длиной 51–60 знаков, длиннее 70 знаков переписывались почти все. Это данные первого квартала 2022 года, свежих мы не нашли.
Для meta description правило мягче. Google в справке о сниппетах допускает программную генерацию описаний на больших сайтах, если они уникальны для страницы, читаемы и разнообразны. Массовый черновик описаний от модели поэтому допустим, а список ключевых слов вместо описания Google не рекомендует.
С JSON-LD ошибок больше. Авторы LLM4Schema.org проверили GPT-3.5 и GPT-4: 40–50% разметки оказалось невалидной, нефактической или не соответствующей Schema.org. Статья ещё на рецензировании, модели 2023–2024 годов. По оценке авторов, после фильтрации агентами на языковых моделях разметка GPT-4 стала лучше, чем у людей-разметчиков. Разметку от модели поэтому стоит прогонять через валидатор и сверять поля с видимым текстом страницы. Форматы описаны в статье про микроразметку сайта.
В перелинковке и отчётах нейросеть годится как помощник по выгрузке, решение остаётся за человеком. Исследований точности ИИ-перелинковки и ИИ-отчётов мы не нашли, поэтому опираемся на устройство инструментов. Эмбеддинги, числовые описания смысла страниц, в Screaming Frog показывают, какие страницы близки по смыслу. Получается список кандидатов для внутренних ссылок, который редактор просматривает и отбирает.
В отчёте модель пересказывает выгрузку и подсвечивает отклонения. Сводка опирается только на данные из таблицы: без позиций за прошлый месяц в промпте рассуждать о динамике модели не на чем. Пока исходная таблица рядом, каждую цифру сводки можно сверить с ней.
SEO AI вредит, когда модель подменяет данные, когда страницы идут потоком без редактора и когда уникальный текст принимают за полезный.
Видимость в ответах нейросетей — отдельная задача со своими приёмами. Мы сравнили её с классическим SEO в статье GEO или SEO для нейросетей, а работу над ней ведём в услуге GEO/AEO.
На SEO-конвейере Звонко черновик пишет модель, за текст отвечает редактор, а до публикации текст проходит фактчек и три порога. Опыт описан в кейсе SEO-конвейера для беттинг-партнёрки из топ-15 рынка (клиент под NDA). Текст ниже любого порога возвращается автору с правками:
По данным кейса Звонко, с первого раза проверки проходят 94–96% статей. Финальная правка занимает у редактора от 5 до 12 минут на статью. Порогов три, потому что одна уникальность пропускала правильные слова в правильном порядке без смысла. Фактчек сначала стоял в конце, и автор успевал закрепить неточности. После переноса проверки сразу за черновиком возвратов на доработку стало втрое меньше.
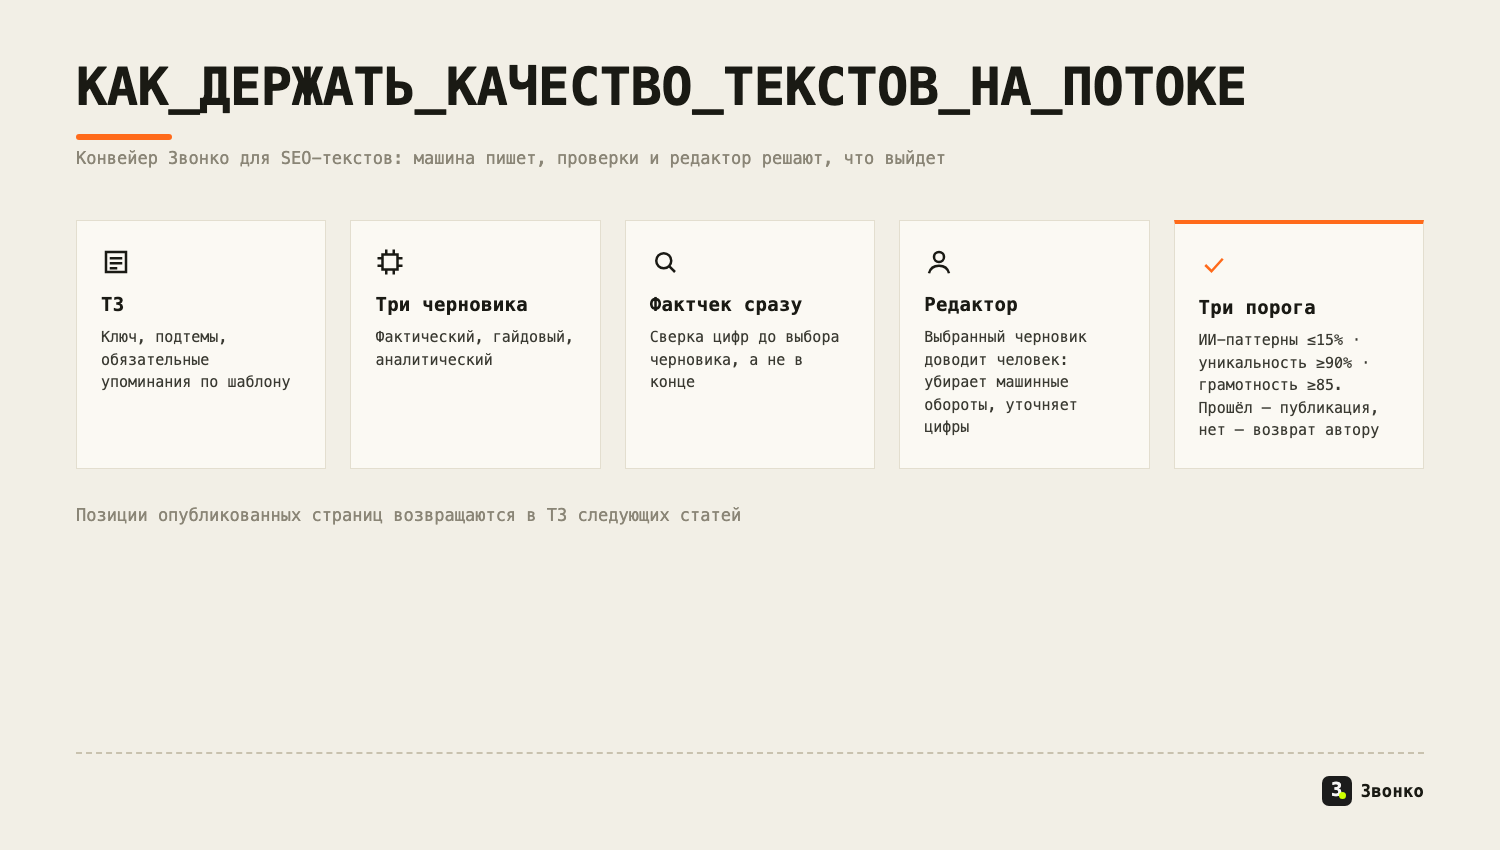
Фактчек стоит сразу после черновика, позиции возвращаются в следующие ТЗ.
За два месяца конвейер выпустил больше 245 статей. Цикл от ТЗ до публикации в CMS сократился с 5 дней до 20 минут; правка редактора, те самые 5–12 минут, идёт внутри этого цикла. Органический трафик из поиска за восемь месяцев вырос в 2,4 раза, но в него могут входить и страницы, написанные до конвейера. Себестоимость статьи снизилась на 40% по данным кейса, раньше при ручном процессе она была около 8 000 ₽. Позиции после публикации служат обратной связью для ТЗ следующих статей, проверкой текста их не считаем.
Собрать такой конвейер под свою тематику можно в услуге контент-автоматизации: мы в Звонко настраиваем пороги и фактчек под задачи клиента. Как устроена система целиком, описано в статье про контент-завод, обзор инструментов для текстов есть в материале про нейросети для создания контента.
Следующую задачу стоит подключать, когда у предыдущей появился человек, который отвечает за проверку. Чего мы пока не знаем: насколько точно нынешние ChatGPT, Claude, Алиса AI и Гигачат называют частоты русских запросов. Публичного теста со сверкой по Вордстату мы не нашли, и до него частоты от любой модели считаем догадкой.
Нейросеть пишет SEO-тексты быстро, а проверка съедает выигрыш? Настроим конвейер, где фактчек стоит сразу после черновика, а слабый текст не проходит пороги до публикации. Первые 10 текстов — бесплатно.
Обсудить контент-автоматизацию →Не стоит. Google в руководстве по использованию генеративного ИИ просит вручную проверять весь ИИ-контент на точность перед публикацией и объясняет, что модели не достают факты, а предсказывают вероятную последовательность слов. Справка Яндекса об ЭПОС допускает помощь нейросети автору, но не замену автора. На SEO-конвейере Звонко черновик пишет модель, а финальную правку делает редактор, у которого на статью уходит 5–12 минут.
Идеи запросов и группировку готового списка доверить можно, частоты нельзя. В тесте Dejan модель оценивала объём запросов по показам Search Console и угадала точную корзину частоты только в 35% случаев. Поэтому у модели просят уровни спроса, а числа берут из Вордстата. Тест сделан на Gemini в 2025 году, свежего публичного теста на русских запросах мы не нашли.
Нет. Без выгрузки обхода модель сайт целиком не видит, а краулеры ChatGPT и Claude, по данным Vercel за 2024 год, не исполняют JavaScript и читают только исходный HTML. Открытых замеров точности ИИ-аудитов мы не нашли. Рабочая схема такая: краулер, то есть программа обхода сайта, собирает данные, модель разбирает выгрузку, человек проверяет выводы по самим страницам.
Способ создания в политике Google критерием не назван. Политика scaled content abuse касается массовых страниц, сделанных ради позиций и без пользы для читателя, и среди примеров называет генерацию многих страниц ИИ-инструментами без добавленной ценности. В исследовании Ahrefs по 100 000 выдач страницы, целиком написанные ИИ, заняли 5,3% мест в топ-3. Это корреляция, а не доказательство причины.
Задайте один вопрос: проверка результата займёт меньше времени, чем сама работа? Если да, отдавайте задачу модели и закладывайте проверку в процесс. Если проверить так же долго или дольше, делайте сами или берите инструмент с данными, например краулер. Близкий вывод даёт исследование Dell'Acqua и соавторов 2026 года: на задачах за пределами возможностей ИИ участники с моделью решали верно на 19 процентных пунктов реже.
Требования к пользе те же: страница должна помогать решить задачу. Справка Яндекс Вебмастера про ЭПОС приводит как пример слабого контента текст, сгенерированный ИИ на основе существующих материалов без дополнительной ценности, и напоминает, что уникальность текста сама по себе ценности не гарантирует.
 Контент-завод
Как создать контент завод на n8n и нейросетях: девять шагов с узлами, тарифы и цены API, места поломок и то, что сценарий не сделает сам: проверку фактов, пороги и редактора.
Читать статью → GEO
Нейросеть берёт источники в два этапа: сначала поиск собирает кандидатов, потом модель отбирает фрагменты. Что подтверждено документацией и данными, что миф.
Читать статью → GEO
Генеративный поиск надстроен над индексом: вопрос дробится на подзапросы, система отбирает фрагменты страниц и пересказывает их. Как это устроено у Google, Алисы AI, ChatGPT и что делать сайту.
Читать статью →Начнём с бесплатного экспресс-замера: покажем, как нейросети видят ваш бренд сейчас и где есть смысл работать.